カイ二乗分布表は、統計的仮説検定において計算した値が偶然の範囲といえるかを判断するための表です。
適合度検定、独立性の検定、分散の検定などで登場しますが、自由度や上側確率の意味を取り違えると、p値や検定結果まで誤ってしまいます。
表に並ぶ数値のどこを読めばよいのか、なぜ右側の面積を見るのか、実際の計算値をどのように比較するのかを順番に整理しましょう。
カイ二乗分布表は計算の答えを探す表ではなく、計算値の珍しさを確率で評価するための表と考えると、全体像をつかみやすくなります。
カイ二乗分布表の見方
それではまずカイ二乗分布表の見方について解説していきます。
表の行と列の役割
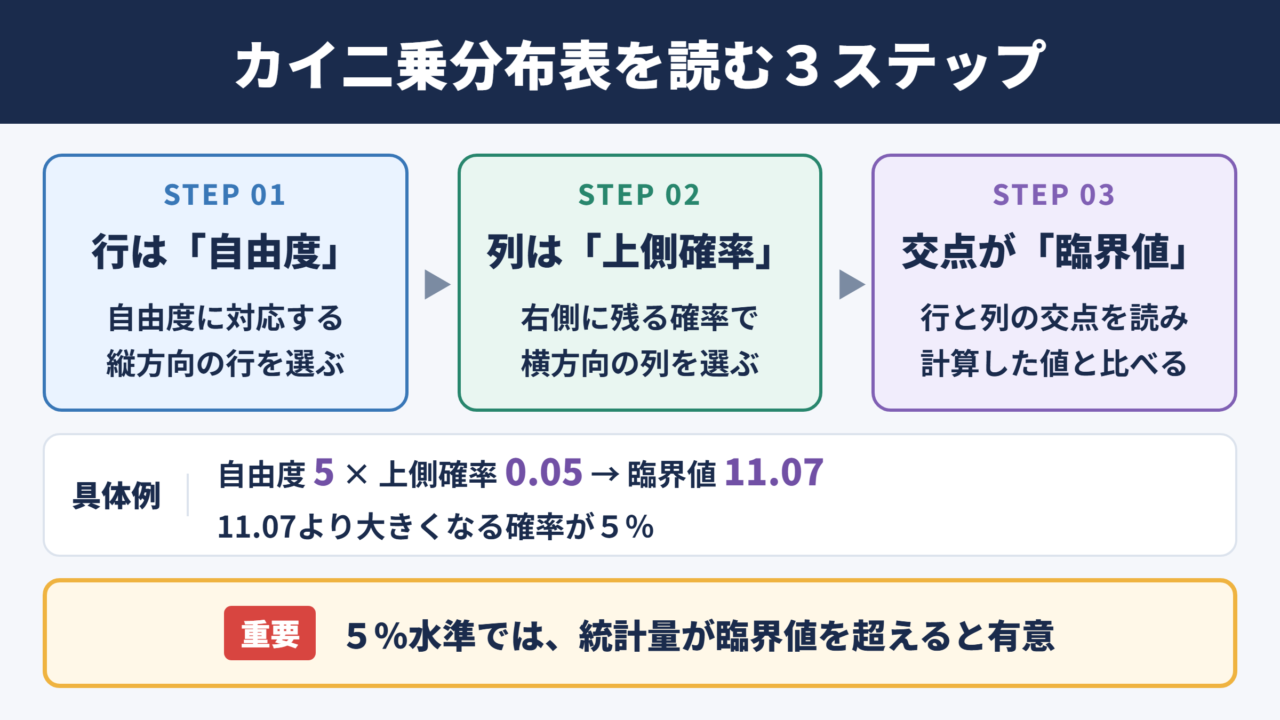
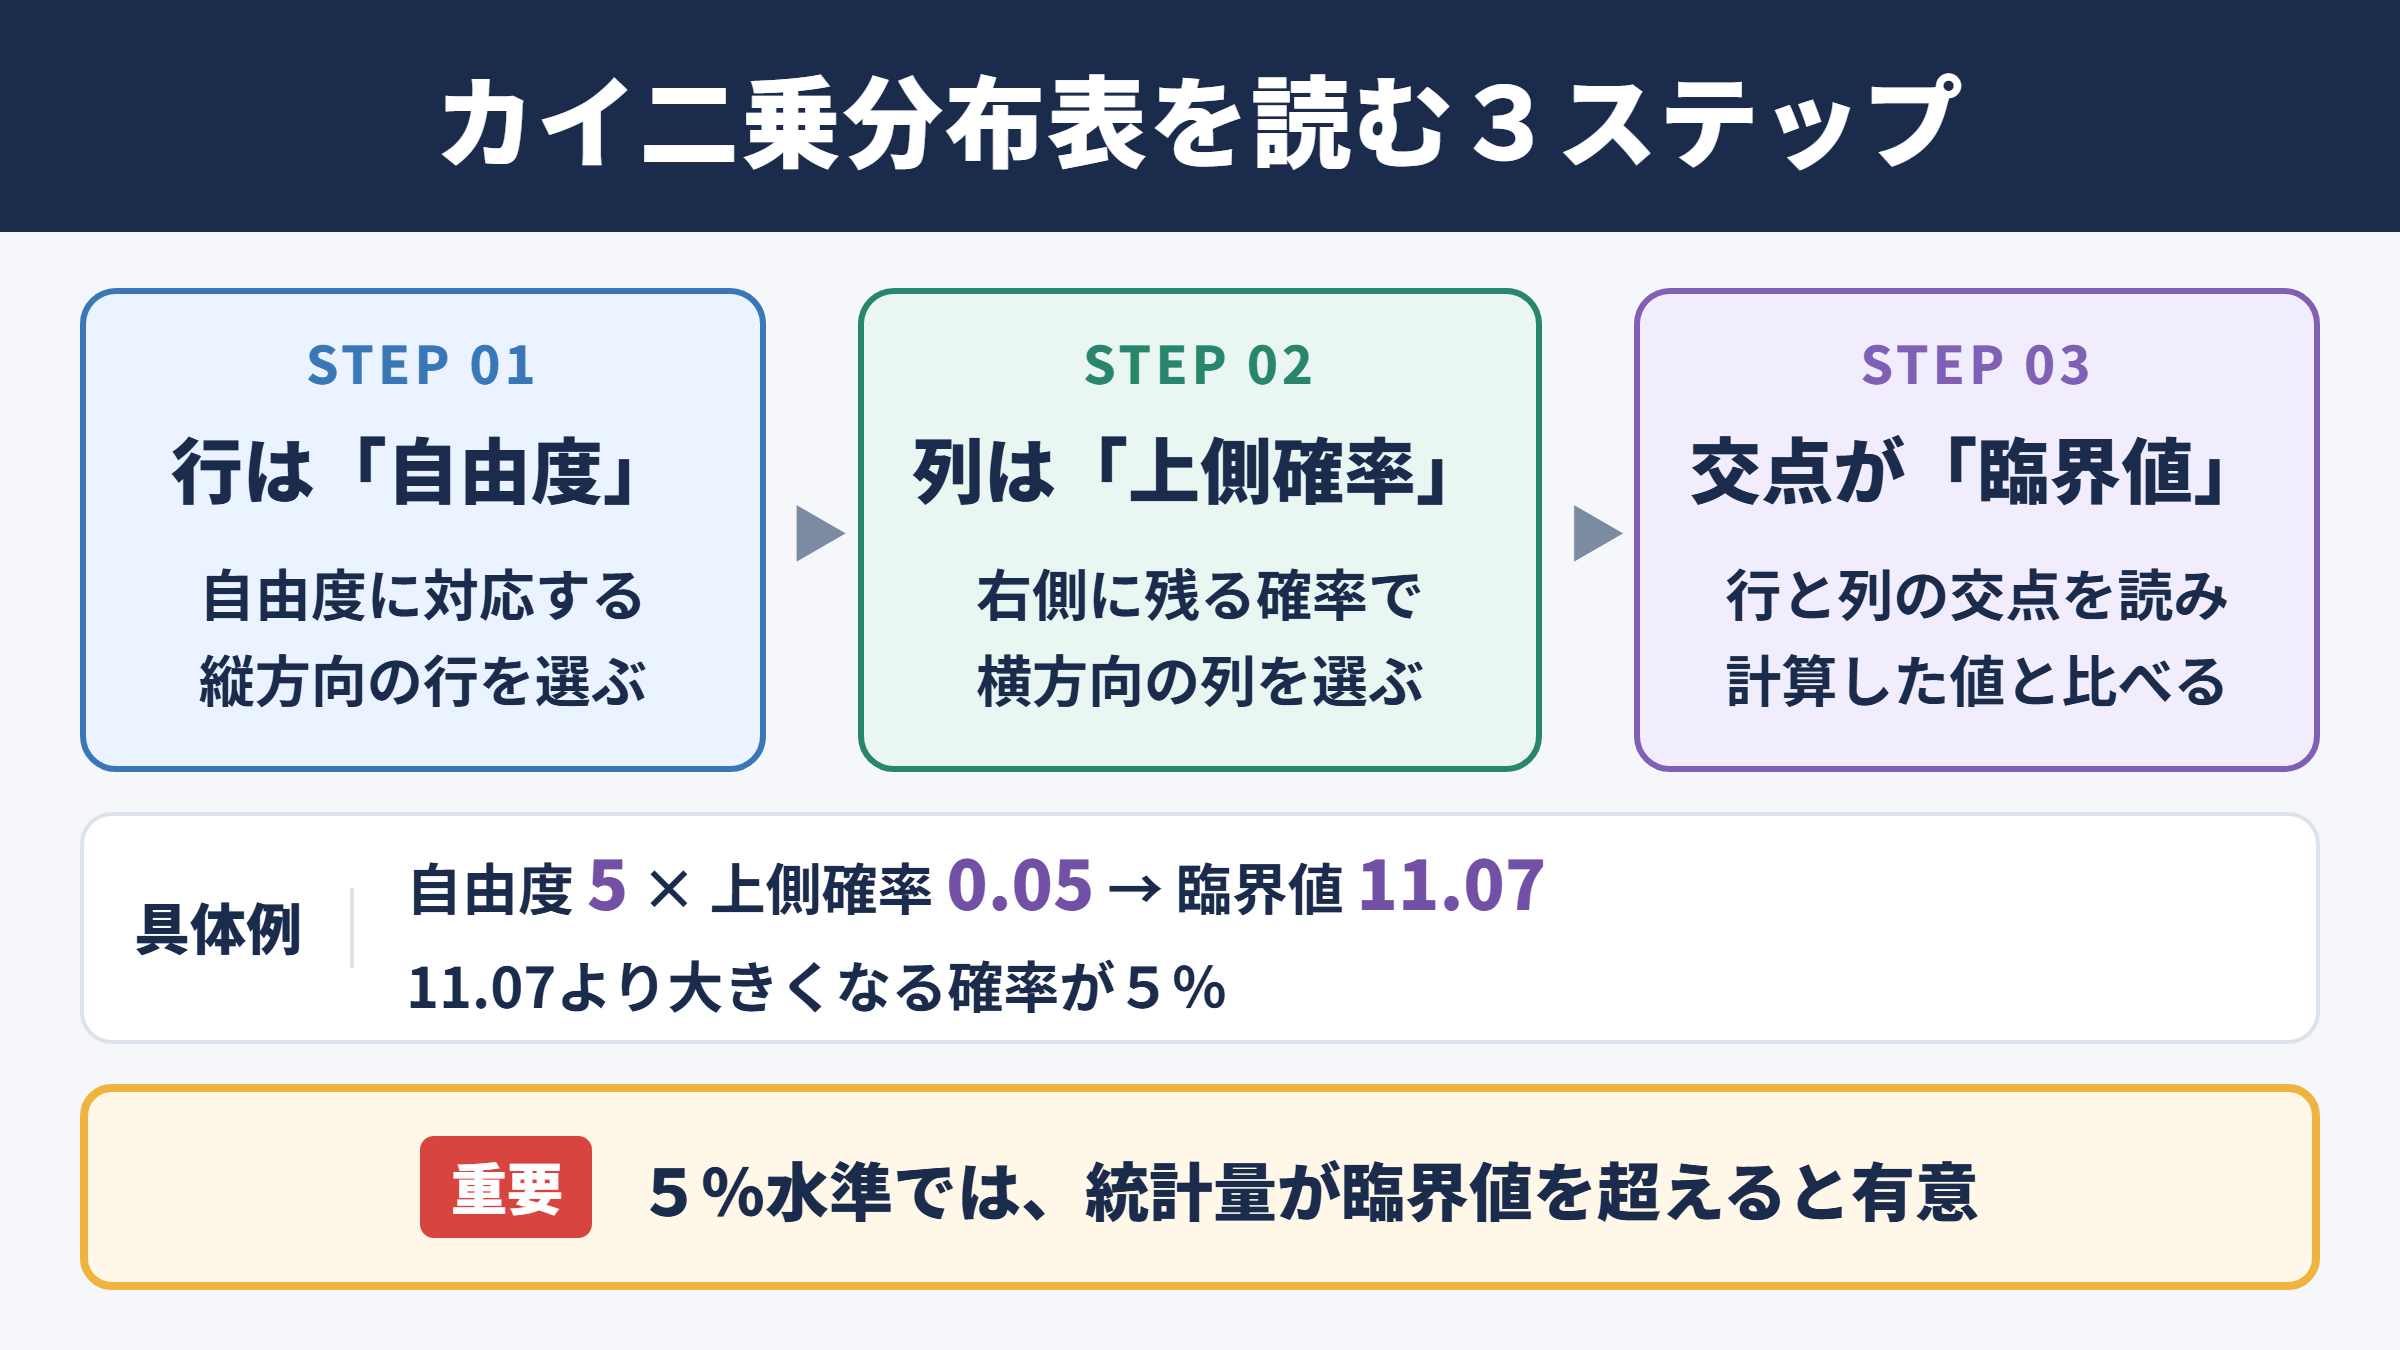
カイ二乗分布表では、一般に縦方向の行に自由度、横方向の列に上側確率が掲載されています。
行と列が交差する場所にある数値は、指定した自由度において、右側に残る確率が指定値になるカイ二乗値です。
たとえば自由度が5で、上側確率が0.05の欄に11.07程度とあれば、カイ二乗値が11.07より大きくなる確率は5パーセントという意味になります。
ここでいう上側とは、分布図を横軸に沿って見たときの右側です。
カイ二乗分布は0以上の値しか取らず、右に長く尾を引く形になりやすいため、検定では大きすぎるカイ二乗値に注目する場面が多いことを覚えておくとよいでしょう。
| 表の項目 | 意味 | 確認する目的 |
|---|---|---|
| 自由度 | 分布の形を決める値 | 読むべき行を選ぶ |
| 上側確率 | カイ二乗値より右側の面積 | 有意水準やp値を確認する |
| パーセント点 | 確率に対応する境界の値 | 計算値と比較する |
| カイ二乗統計量 | データから計算した値 | 仮説を棄却するか判断する |
上側確率とパーセント点の関係
カイ二乗分布表の数値は、パーセント点や臨界値と呼ばれます。
上側確率が0.05のパーセント点は、右側に5パーセントの面積を残す位置にある値です。
有意水準を5パーセントとする検定では、計算したカイ二乗統計量がこの値を超えた場合に、帰無仮説とデータのずれは偶然では説明しにくいと判断します。
自由度5で上側確率0.05のパーセント点が11.07の場合を考えます。
計算したカイ二乗統計量が8.20なら、11.07を超えないため5パーセント水準では有意といえません。
統計量が13.40なら、11.07を超えるため5パーセント水準で有意と判断します。
ただし、これはp値そのものを正確に求めたわけではありません。
表で確認できるのは、p値が0.05より小さいかどうか、あるいは複数の確率列の間のどこに位置するかという範囲です。
検定結果へつなげる基本手順
表を使う手順は、自由度を求める、カイ二乗統計量を計算する、採用する有意水準の列を選ぶ、該当するパーセント点と比較するという流れです。
検定前には帰無仮説と対立仮説を明確にし、どのような差や関連を確かめたいのかを決めておく必要があります。
独立性の検定であれば、帰無仮説は二つのカテゴリ変数に関連がないこと、対立仮説は関連があることになります。
計算値が臨界値を超えれば、帰無仮説のもとでこのような大きなずれが出る可能性は低いと考え、帰無仮説を棄却します。
表の数値より統計量が大きいとき、対応する上側確率よりp値は小さくなります。
比較の向きを逆にすると結論も反転してしまうため、右側確率を見る表であることを毎回確認しましょう。
自由度の意味
続いては自由度の意味を確認していきます。
自由度が表す情報量
自由度とは、複数の値を決めるときに自由に動かせる値の個数を表す考え方です。
統計では、合計値や平均値などの条件が決まることで、一部の値が自動的に決まります。
たとえば合計が10となる3個の数値を考える場合、最初の2個を決めると最後の1個は合計を満たすように決まります。
このとき自由に決められる数は2個であり、自由度は2です。
カイ二乗分布では自由度によって分布の形が変化します。
自由度が小さいほど右に長い裾を持つ非対称な形になり、自由度が大きくなるにつれて左右の偏りは緩やかになります。
同じカイ二乗値でも自由度が異なれば、珍しさを表すp値は変わるため、自由度の選択は欠かせません。
適合度検定における自由度
適合度検定は、観測度数が理論上の期待度数にどの程度一致しているかを確認する検定です。
カテゴリ数をkとし、理論上の割合を外部からあらかじめ決めている場合、自由度は通常kから1を引いた値になります。
合計度数が固定されているため、最後のカテゴリの度数は他のカテゴリとの関係で決まるからです。
6種類の商品の売上割合が、あらかじめ決めた比率に従っているかを適合度検定で調べる場合を考えます。
推定する母数がなければ、自由度は6から1を引いた5です。
データから平均や割合などの母数を推定して期待度数を作った場合は、推定した母数の数も自由度から差し引きます。
たとえば正規分布への適合度を確認する際に、標本から平均と標準偏差を推定したなら、カテゴリ数から1と推定母数2個を引く考え方になります。
分析ソフトが自由度を自動計算する場合でも、どの前提で計算されているかを確認する姿勢が重要です。
独立性の検定における自由度
クロス集計表で用いる独立性の検定では、自由度は行数と列数から計算します。
行数をr、列数をcとすると、自由度はrから1を引いた値とcから1を引いた値の積です。
つまり自由度は、r−1とc−1の積となります。
| クロス集計表 | 自由度の計算 | 自由度 |
|---|---|---|
| 2行2列 | 1と1の積 | 1 |
| 2行3列 | 1と2の積 | 2 |
| 3行3列 | 2と2の積 | 4 |
| 4行5列 | 3と4の積 | 12 |
性別と購入有無のような2行2列の表では自由度は1です。
年代を3区分、満足度を4区分にした表なら、自由度は2と3の積で6になります。
行や列が増えると自由度も増えるため、使用するカイ二乗分布表の行を間違えないよう注意しましょう。
上側確率とp値
続いては上側確率とp値の関係を確認していきます。
上側確率の考え方
上側確率とは、観測されたカイ二乗統計量以上の値が得られる確率です。
分布の右端へ進むほど大きな値は出現しにくくなるため、右側の面積は小さくなります。
帰無仮説が正しいと仮定したときに、観測値以上のずれが起きる確率が十分に小さければ、その仮説はデータと整合しにくいと判断します。
これがカイ二乗検定で上側確率を確認する理由です。
なお、分散の検定では目的によって両側検定や下側確率を考慮することがあります。
使用する表が上側確率表なのか、下側確率表なのかは、表の見出しで必ず確認してください。
p値の読み取り方
p値は、帰無仮説が正しいとした場合に、観測結果と同程度以上に極端な結果が得られる確率です。
p値が0.05未満なら5パーセント水準で有意、0.01未満なら1パーセント水準で有意と表現することが多いでしょう。
カイ二乗分布表には0.10、0.05、0.025、0.01、0.005などの上側確率が並ぶことがあります。
統計量がどのパーセント点の間にあるかを見れば、p値のおおよその範囲がわかります。
| 統計量の位置 | p値の範囲 | 5パーセント水準の判断 |
|---|---|---|
| 0.10列の値より小さい | p値は0.10より大きい | 有意ではない |
| 0.10列と0.05列の間 | 0.05より大きく0.10より小さい | 有意ではない |
| 0.05列と0.01列の間 | 0.01より大きく0.05より小さい | 有意 |
| 0.01列の値より大きい | p値は0.01より小さい | 非常に有意 |
p値が小さいことは、帰無仮説が正しい確率が小さいことを直接意味するわけではありません。
あくまで帰無仮説を前提にした条件付きの確率であり、結果の解釈では効果量、標本サイズ、研究目的もあわせて確認する必要があります。
有意水準との違い
有意水準は、検定を始める前に設定する判断基準です。
一方のp値は、実際のデータから得られたカイ二乗統計量に基づく結果です。
有意水準を0.05に設定し、p値が0.03だったならp値は基準未満なので帰無仮説を棄却します。
p値が0.08なら基準を超えるため、帰無仮説を棄却するだけの根拠は得られなかったという結論になります。
有意ではないという結果は、二つの変数に差や関連が絶対にないことの証明ではありません。
標本数が少ない、効果が小さい、測定のばらつきが大きいといった理由で、差を検出できない可能性も残ります。
パーセント点の活用
続いてはパーセント点の活用方法を確認していきます。
臨界値による判定
パーセント点を臨界値として使う方法は、手計算や試験問題でもわかりやすい判断方法です。
まず有意水準を決め、自由度に対応する行と上側確率に対応する列を探します。
交点のパーセント点より計算した統計量が大きければ、棄却域に入ったと判断します。
カイ二乗検定の棄却域は、通常は分布の右側に設定されます。
観測度数と期待度数の差が大きいほど統計量が大きくなり、期待したモデルとの不一致が疑われるためです。
p値の範囲による表現
カイ二乗分布表だけを使う場合、p値を小数点以下まで正確に算出できないことがあります。
その場合は、p値が0.05未満、p値が0.01以上0.05未満のように範囲で表現します。
論文や報告書では、統計ソフトで得られた正確なp値を示す方法が一般的です。
ただし、表による確認はソフトの出力を検算し、検定の仕組みを理解するために役立ちます。
自由度4でカイ二乗統計量が10.20だったとします。
自由度4の上側確率0.05のパーセント点は9.49程度であり、0.01のパーセント点は13.28程度です。
したがってp値は0.01より大きく0.05より小さい範囲で、5パーセント水準では有意となります。
このように、隣り合う列の値を利用すると、表に直接掲載されていないp値でも概算できます。
統計量が大きいほど上側確率は小さくなるという逆向きの関係を意識すると、範囲の判断がしやすくなります。
統計ソフトとの使い分け
Excel、R、Python、SPSSなどの統計ソフトでは、カイ二乗統計量と自由度からp値を自動で算出できます。
大規模なデータや複数の検定を扱う場合には、ソフトの利用が効率的でしょう。
一方で、期待度数が正しく計算されているか、自由度が妥当か、片側か両側かといった設定の確認は分析者が担う部分です。
出力されたp値だけを見て終えるのではなく、クロス集計表の実数、割合、残差も確認することが大切です。
有意差が出た場合には、どのカテゴリの組み合わせが全体の差に寄与したのかを標準化残差で検討する方法もあります。
カイ二乗検定の計算
続いてはカイ二乗検定の計算の流れを確認していきます。
観測度数と期待度数
カイ二乗検定では、実際に得られた人数や件数を観測度数と呼びます。
帰無仮説が正しいとした場合に期待される人数や件数は期待度数です。
独立性の検定では、各セルの期待度数を行合計と列合計の積を総数で割って求めます。
観測度数と期待度数が近ければ、独立であるという仮説と整合的です。
差が大きいセルが多いほど、二つの変数の間に関連がある可能性が高まります。
カイ二乗統計量の式
カイ二乗統計量は、各セルについて観測度数から期待度数を引いた差を二乗し、期待度数で割った値を合計して計算します。
式では、各セルの観測度数をO、期待度数をEとして、OとEの差の二乗をEで割る値をすべて足し合わせます。
差を二乗するため、観測度数が期待度数より多い場合も少ない場合も、ずれとして加算されます。
期待度数で割る理由は、規模が異なるセル間でもずれを比較しやすくするためです。
あるセルで観測度数が30、期待度数が24だった場合を考えます。
差は6であり、差の二乗は36です。
36を期待度数24で割ると、このセルのカイ二乗統計量への寄与は1.5となります。
各セルの寄与を合計した値が最終的なカイ二乗統計量です。
ずれが大きいだけでなく、期待度数に比べてどれほど大きいずれかによって、統計量への影響は変化します。
期待度数の条件と注意点
カイ二乗検定では、期待度数が極端に小さいセルが多いと、近似によるp値の精度が低下することがあります。
一般には、期待度数が5未満のセルが多すぎないことが目安として用いられます。
2行2列の小さな表で度数が少ない場合には、フィッシャーの正確確率検定を検討する場面もあります。
カテゴリを必要以上に細分化すると、各セルの期待度数が小さくなりやすいため注意が必要です。
逆に、意味の異なるカテゴリを安易にまとめると、分析したい差が見えにくくなる可能性があります。
カイ二乗検定を行う前に、各セルの期待度数とデータの独立性を確認しましょう。
同一人物を重複して数えるデータや、対応のあるデータを通常の独立性の検定に入れると、前提に合わない結論になるおそれがあります。
結果の解釈と注意点
続いては結果の解釈と注意点を確認していきます。
有意差と実務上の重要性
p値が有意水準未満であれば、統計的には帰無仮説を棄却できます。
しかし、統計的有意差があることと、実務上の差が大きいことは同じではありません。
標本数が非常に多い場合は、わずかな差でも有意になりやすい傾向があります。
そのため、クロス集計表の割合や差の大きさを確認し、必要に応じてクラメールのVなどの効果量も併記するとよいでしょう。
p値だけで結論を急がず、差の方向と大きさを数値で読むことが、実用的な分析につながります。
関連と因果関係の違い
独立性の検定で有意な結果が出た場合、二つの変数には統計的な関連があると解釈できます。
ただし、それだけで一方が他方の原因であるとはいえません。
たとえば年齢層と商品選択に関連が見られても、所得、生活環境、利用機会など別の要因が影響している可能性があります。
因果関係を検討するには、研究デザイン、時系列、交絡要因、追加の分析を含めた慎重な検討が必要です。
報告書における記載方法
分析結果を報告する際は、カイ二乗統計量、自由度、p値、標本数を示すと内容が伝わりやすくなります。
加えて、どの比較を行ったのか、期待度数の条件を満たしているか、効果量を確認したかも必要に応じて記載します。
文章では、二つの変数に有意な関連が認められた、あるいは有意な関連は認められなかったというように、検定対象を明示するとよいでしょう。
有意ではなかった結果も、検討した範囲では明確な関連を示す証拠が得られなかったという重要な情報になります。
まとめ
カイ二乗分布表は、自由度と上側確率を手がかりに、カイ二乗統計量がどの程度珍しい値なのかを判断するための表です。
表の行では自由度を選び、列では有意水準や上側確率を選び、交点にあるパーセント点と計算値を比較します。
計算した統計量がパーセント点を超える場合、p値は対応する上側確率より小さくなります。
自由度、期待度数、上側確率の三つを正しく確認することが、カイ二乗検定を正確に読む基本です。
また、p値が小さいという結果だけで判断せず、クロス集計の割合、効果量、データの前提条件、実務上の意味まであわせて解釈しましょう。
カイ二乗分布表の仕組みを理解しておけば、統計ソフトの出力をより確信を持って読み取り、適合度検定や独立性の検定を適切に活用できるようになります。