カイ二乗分布は、分散の信頼区間を求める場面や、観測結果に偏りがあるかを確かめる適合度検定、二つのカテゴリに関連があるかを見る独立性検定で使われる確率分布です。
数式だけを見ると難しく感じやすい一方で、自由度、カイ二乗値、有意水準という三つの要素を順に整理すれば、表や統計ソフトの結果も読み解きやすくなります。
この記事ではカイ二乗分布の計算方法を、基本の式、具体的な例題、信頼区間と有意水準の関係まで、初学者にもつながりが見える形で解説します。
カイ二乗分布の計算手順
それではまずカイ二乗分布の計算手順について解説していきます。
カイ二乗分布の意味
カイ二乗分布とは、標準正規分布に従う複数の値を二乗して合計したときに現れる分布です。
二乗を使うため値は必ず〇以上となり、左右対称ではなく、右側に長く伸びる形になりやすい点が特徴です。
標本分散を扱うときには、母集団が正規分布に従うという前提のもとで、標本分散をカイ二乗分布へ変換できます。
分散の推定では、標本平均ではなく標本のばらつきに注目するため、カイ二乗分布が重要な役割を持ちます。
また、カテゴリ別の人数を比較する検定では、実際に得られた度数と、仮説が正しいとした場合に期待される度数の差を二乗して使います。
符号の違いを打ち消さず、ずれの大きさを評価できることが二乗する理由です。
基本式と自由度
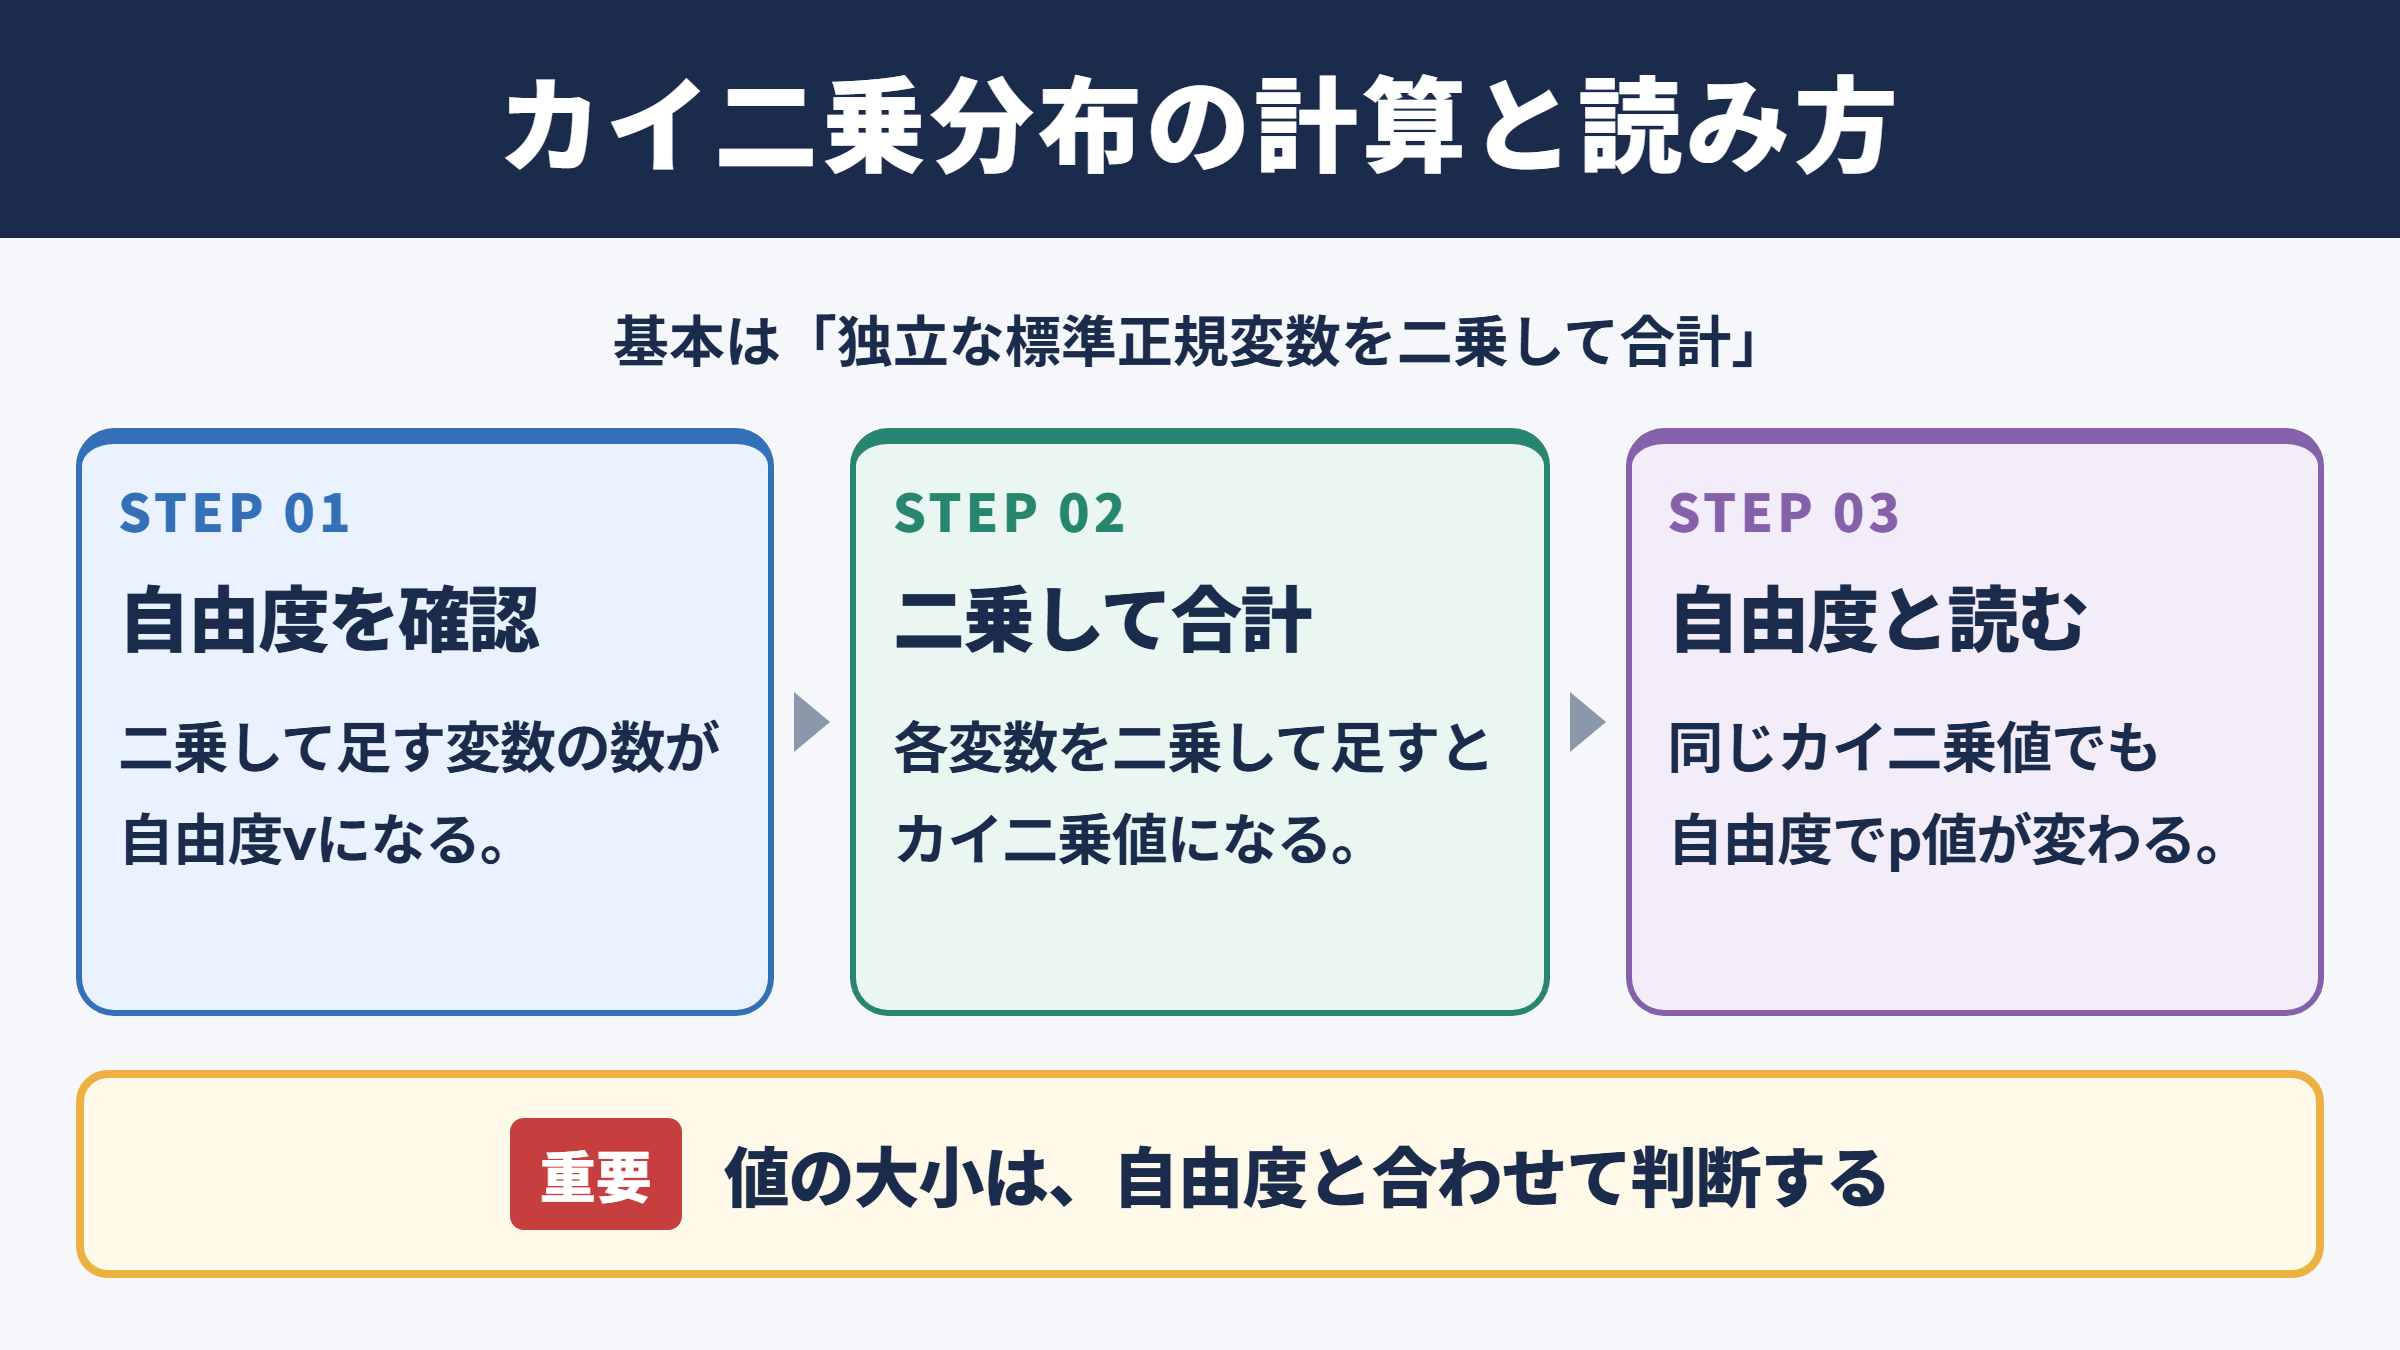
標準正規分布に従う独立な確率変数を Z1、Z2、Z3 と続けて考え、それらを二乗して足した値を X とします。
X = Z1の二乗 + Z2の二乗 + … + Zνの二乗
このとき X は自由度νのカイ二乗分布に従います。
ここでいう自由度は、自由に動かせる情報の数を表す考え方です。
たとえば標本から平均との差を計算すると、平均との差の合計は必ず〇になるため、n個のデータがあっても自由度は通常 n-1 になります。
自由度が小さいほど分布は右に大きくゆがみ、自由度が増えるほど山の位置は右へ移り、形はなだらかになります。
カイ二乗分布を使う計算では、自由度の設定を誤ると臨界値も信頼区間も変わるため、最初に確認することが大切です。
計算結果の読み方
カイ二乗値は、観測値が仮説からどの程度離れているか、または標本分散がどの程度大きいかを示す数値です。
ただし、値そのものだけで大きいか小さいかを判断することはできません。
同じカイ二乗値でも自由度が異なれば、珍しさを表す確率である p値は変わるためです。
判断では、自由度と有意水準に対応した臨界値をカイ二乗分布表から探し、計算値と比べます。
カイ二乗分布の計算は、値を出して終わりではありません。
自由度、有意水準、片側か両側かをそろえたうえで、棄却域または信頼区間と照らし合わせる流れが基本です。
分散の信頼区間の算出式
続いては分散の信頼区間の算出式を確認していきます。
母分散と標本分散の関係
母集団の分散を σの二乗、標本サイズを n、不偏分散を sの二乗とします。
母集団が正規分布である場合、次の値は自由度 n-1 のカイ二乗分布に従います。
カイ二乗値 = (n-1)sの二乗 ÷ σの二乗
自由度 = n-1
この式は未知である母分散 σの二乗を、標本から得た不偏分散 sの二乗を使って推定するための出発点です。
平均の信頼区間で使う t分布とは異なり、分散の信頼区間ではカイ二乗分布の左右両側の値を利用します。
分散の信頼区間は一般に左右非対称です。
これはカイ二乗分布自体が対称ではないことに由来します。
信頼係数と両側確率
信頼係数を九五パーセントとする場合、信頼区間の外側に残す確率は合計で五パーセントです。
両側区間では、通常その五パーセントを左右に二・五パーセントずつ割り当てます。
カイ二乗分布表には、右側確率に対応する値が掲載されていることが多いため、表の見出しが右側確率か左側累積確率かを必ず確認しましょう。
| 項目 | 九五パーセント信頼区間の場合 | 確認する内容 |
|---|---|---|
| 有意水準 | 〇・〇五 | 区間の外に置く確率 |
| 片側確率 | 〇・〇二五 | 左右それぞれに配分する確率 |
| 下限の計算 | 大きいカイ二乗値を使用 | 分母が大きいほど下限は小さくなる |
| 上限の計算 | 小さいカイ二乗値を使用 | 分母が小さいほど上限は大きくなる |
表の値を式へ代入するときに、下限と上限で使う臨界値を逆にしやすい点には注意が必要です。
分母に入る値の大小を考えると、取り違えを防ぎやすくなります。
信頼区間の一般式
自由度を ν、両側有意水準を αとし、右側確率に対応するカイ二乗値を用いる場合を考えます。
母分散の下限 = νsの二乗 ÷ カイ二乗値の大きい側
母分散の上限 = νsの二乗 ÷ カイ二乗値の小さい側
表記方法は資料によって異なるため、カイ二乗の添え字が左側確率なのか右側確率なのかを読み替える必要があります。
式の記号だけを暗記するより、下限には大きい分母、上限には小さい分母が入ると理解するほうが実務で役立ちます。
母標準偏差の信頼区間が必要な場合は、母分散の下限と上限それぞれについて正の平方根を取ります。
カイ二乗分布の例題計算
続いてはカイ二乗分布の例題計算を確認していきます。
標本分散からの計算例
ある工程から無作為に一〇個の製品を抽出し、不偏分散が四だったとします。
母分散が九であると仮定した場合、自由度は九であり、カイ二乗値は次のように計算できます。
カイ二乗値 = 九 × 四 ÷ 九
カイ二乗値 = 四
この四という値が自由度九の分布においてどの位置にあるかを、分布表または統計ソフトで確認します。
値が極端に小さいか極端に大きいときは、仮定した母分散との整合性に疑問が生じるでしょう。
一方で分布の中央に近い範囲であれば、標本のばらつきは仮定と矛盾しにくいと判断できます。
分散の九五パーセント信頼区間の例
標本サイズが二〇、不偏分散が二五の場合を考えます。
自由度は一九です。
自由度一九における九五パーセント信頼区間用のカイ二乗臨界値を表から取得し、仮に小さい側を八・九、 大きい側を三二・九として計算します。
下限 = 一九 × 二五 ÷ 三二・九
上限 = 一九 × 二五 ÷ 八・九
母分散の信頼区間は、およそ一四・四から五三・四となります。
ここで用いた臨界値は説明のための概算です。
実際の分析では、使用する表や統計ソフトに表示された正確な値を用いてください。
分散の区間推定では、同じデータでも信頼係数を高くするほど区間が広がる傾向があります。
適合度検定の例
次に、六〇人が三つの選択肢を均等に選ぶと仮定した調査を考えます。
均等であれば各選択肢の期待度数は二〇人です。
実際の観測度数が二六人、一八人、一六人だった場合、各カテゴリのずれを計算します。
カイ二乗値 = (二六-二〇)の二乗 ÷ 二〇 + (一八-二〇)の二乗 ÷ 二〇 + (一六-二〇)の二乗 ÷ 二〇
カイ二乗値 = 一・八 + 〇・二 + 〇・八
カイ二乗値 = 二・八
推定した母数がない単純な適合度検定なら、自由度はカテゴリ数三から一を引いた二です。
計算値二・八を自由度二の臨界値と比較し、有意水準五パーセントで棄却域に入るかを判断します。
有意水準とp値の判断基準
続いては有意水準とp値の判断基準を確認していきます。
有意水準の役割
有意水準とは、実際には差や関連がないにもかかわらず、あると誤って判断する危険をどこまで許容するかを示す基準です。
よく使われる有意水準は五パーセントですが、研究分野、品質管理、意思決定の影響によって一パーセントや一〇パーセントを用いることもあります。
有意水準五パーセントとは、帰無仮説が正しいと仮定した場合に、今回の結果以上に極端な値が出る確率が五パーセント未満なら、偶然だけでは説明しにくいと考える基準です。
五パーセントは絶対的な合格線ではなく、誤判定のリスクを事前に決めるための約束です。
p値と臨界値の比較
p値は、帰無仮説が正しいとしたときに、観測された値以上に極端な結果が出る確率です。
カイ二乗検定では通常、カイ二乗値が大きいほど仮説とのずれが大きいとみなすため、右側確率を p値として扱います。
| 比較 | 判断 | 意味合い |
|---|---|---|
| p値が有意水準より小さい | 帰無仮説を棄却する | 偶然だけでは説明しにくい差または関連 |
| p値が有意水準以上 | 帰無仮説を棄却しない | 差がないと証明した意味ではない |
| 計算値が臨界値より大きい | 帰無仮説を棄却する | 右側棄却域に入っている |
| 計算値が臨界値以下 | 帰無仮説を棄却しない | 棄却域に達していない |
p値による方法と臨界値による方法は、同じ有意水準を使えば原則として同じ結論に到達します。
報告書では、判断だけでなくカイ二乗値、自由度、p値を併記すると、分析過程を確認しやすくなります。
統計的有意差の注意点
統計的に有意であっても、実務上の差が大きいとは限りません。
標本サイズが非常に大きい場合は、わずかな差でも p値が小さくなりやすいためです。
逆に標本サイズが小さい場合は、意味のある差があっても検出できない可能性があります。
有意差の有無だけで結論を急がず、度数の差、割合の差、効果量、調査設計を合わせて確認しましょう。
カイ二乗検定では、関連の強さを補足する指標としてクラメールのVを用いることがあります。
p値は効果の大きさを直接示す数値ではありません。
適合度検定と独立性検定の使い分け
続いては適合度検定と独立性検定の使い分けを確認していきます。
適合度検定の目的
適合度検定は、一つのカテゴリ変数における観測度数が、あらかじめ想定した比率に合っているかを確かめる方法です。
たとえば商品の色が三色で均等に売れるという仮説や、出生月の人数が特定の比率に従うという仮説を検討するときに使えます。
計算式は、各カテゴリについて観測度数と期待度数の差を二乗し、期待度数で割ったものを合計する形です。
カイ二乗値 = 各カテゴリの(観測度数-期待度数)の二乗 ÷ 期待度数 の合計
期待度数は、帰無仮説が正しいと仮定した場合に各カテゴリへ入ると予測される人数です。
期待度数と観測度数を混同しないことが、適合度検定の最初のポイントです。
独立性検定の目的
独立性検定は、二つのカテゴリ変数に関連があるかを調べる方法です。
たとえば年代と購入商品、広告媒体と申込有無、勤務形態と満足度などの組み合わせをクロス集計表にまとめて検討します。
各セルの期待度数は、行合計と列合計を掛けて総数で割ることで求めます。
期待度数 = 行合計 × 列合計 ÷ 総数
全セルについて観測度数と期待度数の差を計算し、その合計をカイ二乗値とします。
行数を r、列数を cとした場合、自由度は通常、r-1 と c-1 を掛けた値です。
期待度数と前提条件
カイ二乗検定を安定して使うには、期待度数が極端に小さくないことが重要です。
一般的には、各セルの期待度数が五以上であることを一つの目安として確認します。
小さい期待度数が多い場合、カイ二乗分布による近似が十分に機能しないことがあります。
その場合はカテゴリを合理的に統合する、標本数を増やす、二行二列表であればフィッシャーの正確確率検定を検討するなどの対応が考えられます。
検定前には、観測度数だけでなく期待度数の一覧も確認してください。
前提条件を満たさないまま p値だけを採用すると、結論の信頼性が下がるおそれがあります。
独立性検定で有意差が出た場合も、どのセルが差に強く影響したかを残差分析などで追加確認すると理解が深まります。
計算ツールと結果確認の要点
続いては計算ツールと結果確認の要点を確認していきます。
表計算ソフトでの計算
表計算ソフトでは、カイ二乗分布の右側確率、逆関数、カイ二乗検定用の関数を利用できる場合があります。
関数名はソフトの種類やバージョンで異なるため、カイ二乗分布の累積確率、右側確率、逆関数の説明を確認してから使うと安心です。
入力する自由度は整数であり、分散の区間推定なら n-1、クロス集計なら行と列の数から算出します。
表計算ソフトでは計算式をセルに残せるため、データの更新時に再計算しやすい利点があります。
統計ソフトでの出力確認
統計ソフトやプログラミング言語では、検定統計量、自由度、p値がまとめて出力されることが一般的です。
出力を読む際は、検定名、帰無仮説、カイ二乗値、自由度、p値、標本数の順に確認すると整理しやすくなります。
期待度数が表示される場合には、前提条件を満たしているかも確認しましょう。
ソフトが示す p値は便利ですが、入力したカテゴリ、欠損値の扱い、集計範囲が正しいかを確認する作業は省略できません。
報告書への記載方法
分析結果を文章で伝えるときは、単に有意だったと書くよりも、検定条件と数値を示すほうが読み手に伝わります。
たとえば、自由度二のカイ二乗検定の結果、カイ二乗値は六・二であり、五パーセント水準で有意だった、というようにまとめます。
有意でなかった場合も、差がないと断定せず、今回のデータからは明確な差を確認できなかったと表現すると適切です。
信頼区間を報告する場合は、推定対象が母分散なのか母標準偏差なのかを明記してください。
カイ二乗分布の計算方法のまとめ
カイ二乗分布は、正規分布に関係する値の二乗和から成り立つ分布であり、分散の信頼区間、適合度検定、独立性検定で広く利用されます。
計算の基本は、目的に応じたカイ二乗値を求め、自由度と有意水準に対応する分布上の位置を確認することです。
分散の推定では、(n-1)sの二乗を母分散で割る形を使い、カイ二乗分布の両側の値から信頼区間を作ります。
適合度検定と独立性検定では、観測度数と期待度数の差を基にカイ二乗値を算出します。
p値が有意水準より小さいかどうかは重要な判断材料ですが、効果の大きさや期待度数などの前提条件も合わせて見る姿勢が欠かせません。
式、自由度、期待度数、有意水準の四点を順に確認すれば、カイ二乗分布の計算は着実に理解できます。