カイ二乗分布の導出方法は?正規分布から得られる仕組みを解説!(積率母関数・再生性)
カイ二乗分布は、統計学における検定や信頼区間の計算で頻繁に登場する確率分布です。
名称だけを見ると難しく感じられますが、出発点は標準正規分布という身近な分布にあります。
正規分布に従う確率変数を二乗し、独立なものを複数加えると、なぜカイ二乗分布になるのでしょうか。
この記事では導出の流れ、確率密度関数、積率母関数、再生性までをつなげて整理します。
カイ二乗分布の意味と導出の全体像
それではまずカイ二乗分布の基本と、正規分布から導かれる結論について解説していきます。
標準正規分布の二乗和
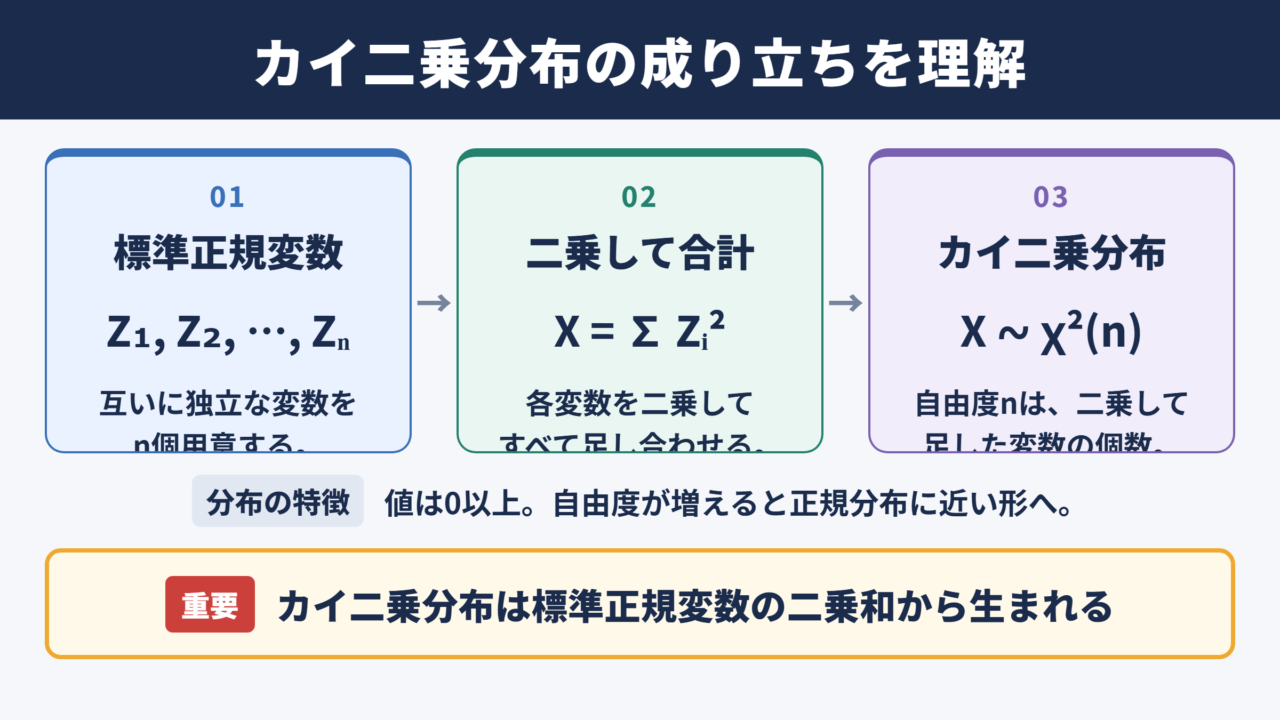
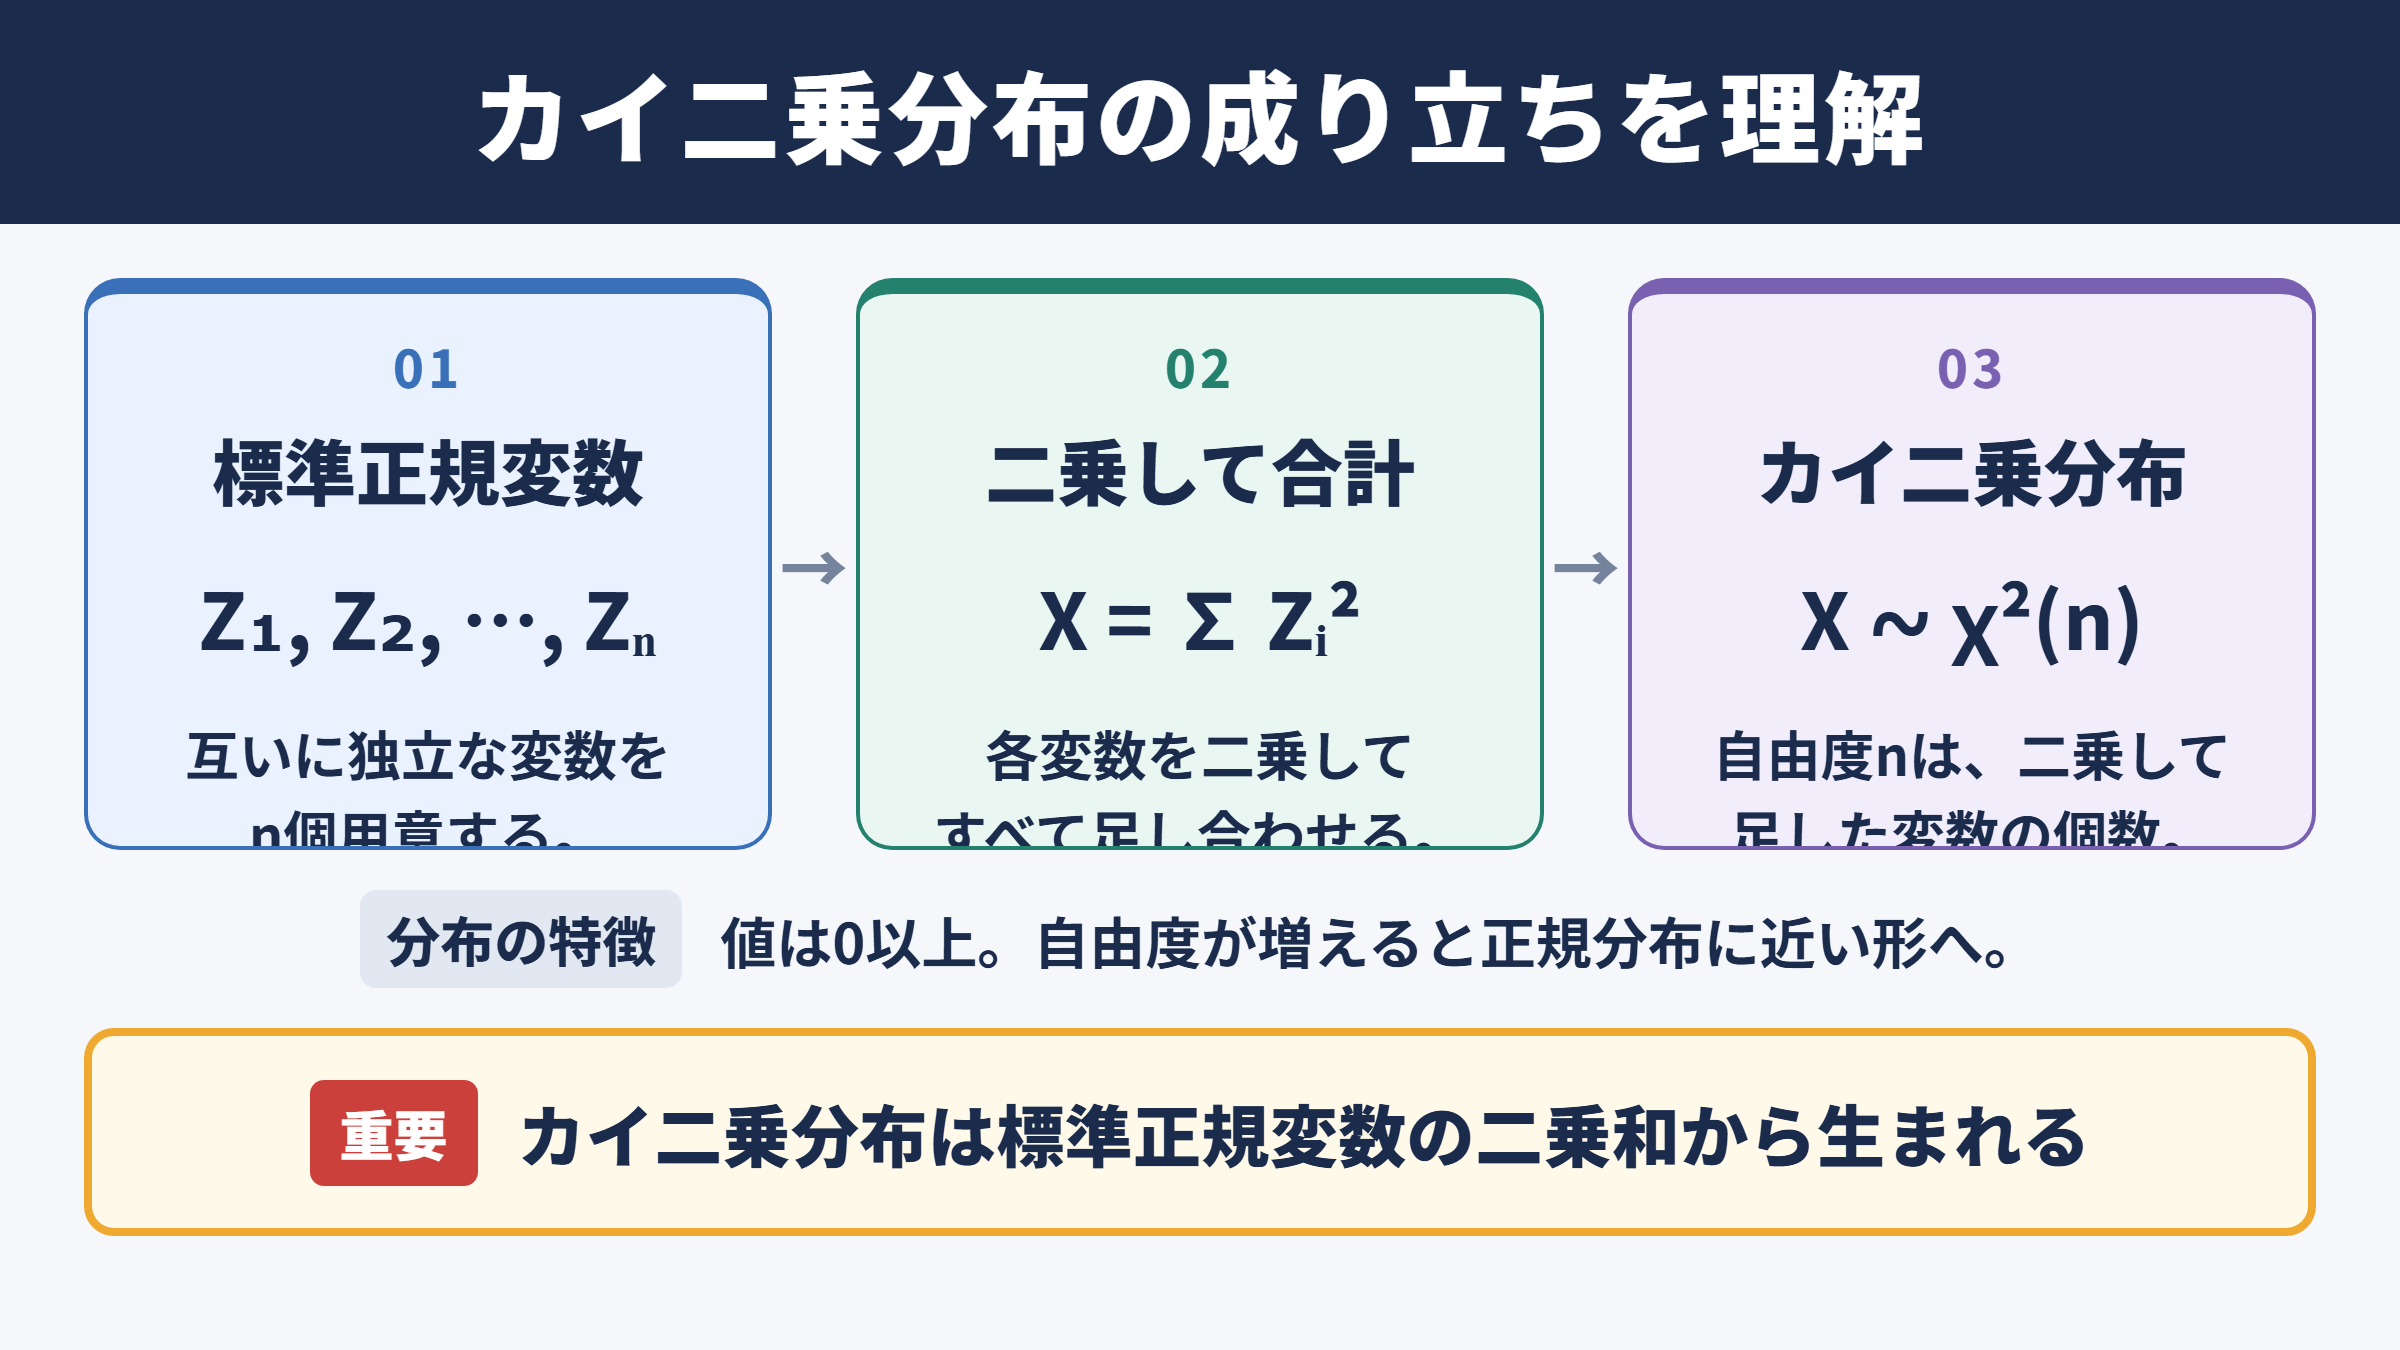
自由度がnのカイ二乗分布とは、互いに独立な標準正規確率変数Z1、Z2、…、Znについて、各変数を二乗して合計した確率変数を指します。
X=Z12+Z22+…+Zn2
Z1、Z2、…、Znが独立に標準正規分布N(0,1)に従うとき、Xは自由度nのカイ二乗分布に従います。
標準正規分布は平均0、分散1の左右対称な分布です。
一方、二乗すると負の値が正になるため、Z2は必ず0以上になります。
この性質により、カイ二乗分布の値域も0以上となり、正規分布のような左右対称の形ではなく右に裾を引く形になります。
カイ二乗分布は正規分布そのものではなく、標準正規変数の二乗和から生まれる分布と押さえることが重要です。
自由度が表す個数
カイ二乗分布の自由度は、二乗して足し合わせる独立な標準正規変数の個数と考えると理解しやすいでしょう。
たとえばZ12だけなら自由度1、Z12+Z22なら自由度2です。
ただし、実際の統計処理では推定した平均を使うことで独立な情報が一つ減り、自由度が標本サイズより小さくなる場面もあります。
標本分散の計算でnではなくn-1が登場する理由も、この自由度と深く結び付きます。
自由度が増えるほど、カイ二乗分布の形は右に偏った状態から次第に正規分布に近い見た目へ変化します。
統計検定における役割
カイ二乗分布は、母分散の推定、適合度検定、独立性の検定、分割表の分析などで利用されます。
観測値と期待値の差を二乗して期待値で割り、その合計を評価するカイ二乗検定は代表例です。
差を二乗するのは、正負の差が打ち消し合わないようにし、大きなずれを明確に評価するためです。
また、自由度に対応した分布を用いれば、得られた統計量が偶然のばらつきとしてどの程度あり得るかを判断できます。
カイ二乗分布を理解する鍵は、標準化された誤差を二乗して合計するという発想です。
検定の公式を覚えるだけでなく、正規分布からの変換として見ると、自由度や右裾の意味まで自然につながります。
標準正規分布の二乗による変数変換
続いては、標準正規変数を二乗したときに確率密度関数がどのように変わるかを確認していきます。
二乗変換と値域の変化
Zが標準正規分布N(0,1)に従うとします。
新しい確率変数としてY=Z2を定めると、Yは負の値を取れません。
Zの値が2でも-2でも、Yの値は4になります。
このように、一つのYに対してZの候補が二つ存在する点が、変数変換で注意すべき部分です。
標準正規分布の確率密度関数は、expを指数関数として、1/√(2π)にexp(-z2/2)を掛けた形です。
二乗変換では、z=√yとz=-√yの二つの経路を考えて密度を合算します。
自由度一の確率密度関数
Y=Z2の確率密度関数を計算すると、yが正の範囲で、1/√(2πy)にexp(-y/2)を掛けた形になります。
これは自由度1のカイ二乗分布の確率密度関数そのものです。
f(y)=1/{21/2Γ(1/2)}・y-1/2・exp(-y/2)
y>0
ここでΓはガンマ関数です。
Γ(1/2)=√πという関係を使うと、標準正規変数を二乗した場合の式と一致します。
自由度1のカイ二乗分布は、標準正規分布を二乗して得られる分布です。
ガンマ分布との対応
カイ二乗分布はガンマ分布の特別な場合としても表せます。
自由度nのカイ二乗分布は、形状母数をn/2、尺度母数を2とするガンマ分布に一致します。
| 分布 | 形状に関する値 | 尺度に関する値 | 値域 |
|---|---|---|---|
| 自由度nのカイ二乗分布 | n/2 | 2 | 0以上 |
| ガンマ分布 | 形状母数α | 尺度母数θ | 0以上 |
| 自由度1のカイ二乗分布 | 1/2 | 2 | 0以上 |
この対応を知っておくと、期待値、分散、加法性などの性質をガンマ分布の知識からも確認できます。
特に、同じ尺度母数を持つ独立なガンマ分布の和が再びガンマ分布になる性質は、カイ二乗分布の再生性につながります。
確率密度関数とガンマ関数の関係
続いては、一般の自由度における確率密度関数とガンマ関数の役割を確認していきます。
一般形の確率密度関数
自由度nのカイ二乗分布の確率密度関数は、xが正の範囲で定義されます。
f(x)=1/{2n/2Γ(n/2)}・xn/2-1・exp(-x/2)
x>0
式のxn/2-1という部分が、自由度によって分布の形を変化させます。
自由度1では0付近の密度が高くなりますが、自由度が大きくなると山の位置は右側へ移ります。
指数関数の部分は、xが大きくなるにつれて密度が減少する右裾の形を作ります。
自由度は単なるラベルではなく、密度関数の指数や山の位置に直接影響する値です。
ガンマ関数による正規化
確率密度関数は、取り得る範囲で積分した値が1にならなければなりません。
カイ二乗分布では、その調整を担うのがガンマ関数です。
ガンマ関数は、正の整数mに対してΓ(m)=(m-1)!という関係を持ちます。
階乗を整数以外にも拡張したものと捉えると、半整数の自由度を含む式にも自然に対応できるでしょう。
自由度が偶数の場合はガンマ関数を階乗で書き換えやすく、手計算の確認にも役立ちます。
自由度が奇数の場合でも、Γ(1/2)=√πを基礎にして式を展開できます。
平均と分散の確認
自由度nのカイ二乗分布の期待値はn、分散は2nです。
つまり自由度が増えると、分布の中心となる位置もばらつきも大きくなります。
| 自由度 | 期待値 | 分散 | 分布の特徴 |
|---|---|---|---|
| 1 | 1 | 2 | 0付近に集中し右裾が長い形 |
| 2 | 2 | 4 | 指数分布に近い減少型 |
| n | n | 2n | 自由度の増加とともに対称形へ近づく傾向 |
標準正規変数の二乗は平均1、分散2を持ちます。
それを独立にn個足すと期待値と分散がそれぞれ加算されるため、nと2nになることも理解できます。
積率母関数による導出
続いては、積率母関数を用いてカイ二乗分布を導く方法を確認していきます。
積率母関数の基本
積率母関数とは、確率変数Xに対してE[exp(tX)]で定義される関数です。
tは一定の範囲で動く実数であり、関数を微分すると期待値や高次の積率を取り出せます。
さらに、積率母関数が存在する範囲では、その関数が分布を一意に定めます。
したがって、二つの確率変数の積率母関数が一致すれば、確率分布も一致すると判断できます。
積率母関数は分布を識別し、独立な確率変数の和を扱いやすくする道具です。
標準正規変数の二乗の計算
Zが標準正規分布に従うとき、Y=Z2の積率母関数を計算します。
定義に標準正規分布の密度関数を代入すると、指数部分を整理することで正規積分の形に変換できます。
計算結果は、tが1/2より小さい範囲で、MY(t)=(1-2t)-1/2となります。
Zが標準正規分布に従うとき、Z2の積率母関数は(1-2t)-1/2です。
この形は、自由度1のカイ二乗分布の積率母関数と一致します。
密度関数を直接変換する方法では正負二つの根を扱いますが、積率母関数を使う方法では和への拡張が特に簡潔になります。
自由度nへの拡張
Z1、Z2、…、Znが独立なら、二乗和Xの積率母関数は各積率母関数の積です。
そのため、(1-2t)-1/2をn回掛けることになります。
結果はMX(t)=(1-2t)-n/2です。
これは自由度nのカイ二乗分布の積率母関数と一致します。
よって、標準正規変数の二乗和は自由度nのカイ二乗分布に従うと結論付けられます。
独立性があるからこそ積率母関数を掛け合わせられ、自由度を足し合わせる導出が成立します。
再生性と自由度の加法性
続いては、カイ二乗分布の再生性と自由度の加法性を確認していきます。
再生性の定義
再生性とは、同じ分布族に属する独立な確率変数を加えたとき、和も同じ分布族に属する性質です。
カイ二乗分布では、独立な二つのカイ二乗確率変数の和が、自由度を足したカイ二乗分布になります。
Xが自由度mのカイ二乗分布、Yが自由度nのカイ二乗分布に従うとします。
XとYが独立なら、X+Yは自由度m+nのカイ二乗分布に従います。
この性質は、標準正規変数の二乗和をまとめ直す考え方と同じです。
前半のm個と後半のn個を別々に合計しても、最終的にm+n個の二乗和である点は変わりません。
積率母関数による再生性の証明
再生性は積率母関数で簡潔に確かめられます。
自由度mのカイ二乗分布の積率母関数は(1-2t)-m/2です。
自由度nのカイ二乗分布の積率母関数は(1-2t)-n/2となります。
独立性により両者を掛けると、(1-2t)-(m+n)/2になります。
この式は自由度m+nのカイ二乗分布の積率母関数です。
自由度の加法性は、指数の和として積率母関数にそのまま現れます。
標本分散とのつながり
正規母集団から得た標本X1、X2、…、Xnを考えます。
母平均μと母分散σ2があるとき、各値を標準化した偏差の二乗和はカイ二乗分布と関連します。
特に標本平均を用いて偏差を計算する場合、平均の推定に一つの情報を使うため自由度はn-1になります。
正規母集団では、(n-1)S2/σ2が自由度n-1のカイ二乗分布に従います。
この関係が、母分散の信頼区間や分散に関する仮説検定の基礎です。
標本分散でn-1を使う背景には、標本平均を推定したことで自由度が一つ減る事情があります。
カイ二乗分布を使う統計的検定
続いては、カイ二乗分布が実際の統計的検定でどのように使われるかを確認していきます。
適合度検定の考え方
適合度検定は、観測された度数が想定した確率分布にどの程度合っているかを調べる方法です。
各分類について観測度数Oと期待度数Eを用意し、差の二乗を期待度数で割って合計します。
統計量が大きいほど、観測値と理論上の期待値のずれが大きいことを意味します。
差を二乗することで正負を打ち消さず、期待値で割ることで分類ごとの規模を調整します。
自由度は通常、分類数から推定した母数の数などを差し引いて決めます。
独立性検定と分割表
独立性検定では、二つのカテゴリ変数に関連があるかを分割表で検討します。
たとえば購買の有無と年代、施策への接触有無と申込み有無などの関係を分析する場面です。
| 申込みあり | 申込みなし | 合計 | |
|---|---|---|---|
| 接触あり | 観測度数 | 観測度数 | 行合計 |
| 接触なし | 観測度数 | 観測度数 | 行合計 |
| 合計 | 列合計 | 列合計 | 総数 |
独立であると仮定したときの期待度数は、行合計と列合計を掛けて総数で割ることで求められます。
二行二列の表では、自由度は通常1です。
表が大きくなるほど自由度も増え、対応するカイ二乗分布を使って有意性を判断します。
利用時の注意点
カイ二乗検定は便利ですが、期待度数が極端に小さい分類が多い場合には近似の精度が下がります。
カテゴリを適切に統合する、別の正確検定を検討するなど、データの状況に応じた対応が必要です。
また、有意差が出たとしても、関連の強さや実務上の重要性まで自動的に示されるわけではありません。
効果量、割合の差、信頼区間も合わせて確認すると、結果をより適切に解釈できます。
カイ二乗検定は差の有無を判断する入口であり、結果の意味は度数表や効果量と一緒に読むことが大切です。
カイ二乗分布の導出方法のまとめ
カイ二乗分布は、独立な標準正規確率変数を二乗し、その和を取ることで得られる確率分布です。
自由度は二乗和に含まれる独立な情報の数を表し、期待値は自由度、分散は自由度の2倍になります。
標準正規変数を一つ二乗すると自由度1のカイ二乗分布になることが、すべての出発点です。
一般の自由度については、確率密度関数をガンマ関数で表す方法と、積率母関数を使う方法があります。
積率母関数では、自由度nの形が(1-2t)-n/2となり、独立な変数の和で積率母関数が掛け算になることから導出できます。
さらに、独立なカイ二乗分布の和が自由度の和を持つカイ二乗分布になる再生性は、標本分散、適合度検定、独立性検定を理解する基盤です。
正規分布、二乗、独立性、自由度、積率母関数という五つの要素を結び付けると、カイ二乗分布の仕組みを体系的に理解できます。