確率分布と統計的な推測とは?数学Bで学ぶ内容と公式を解説!(問題)
数学Bで扱う確率分布と統計的な推測は、たくさんのデータから全体の特徴を読み取り、根拠をもって判断するための単元です。
平均や分散を計算するだけでなく、標本調査、正規分布、区間推定、仮説検定までがつながるため、公式の意味を理解しながら問題演習を進めることが大切になります。
この記事では、数学Bで学ぶ確率分布と統計的な推測の要点、主要な公式、典型問題の考え方を順に解説します。
確率分布と統計的な推測の全体像
それではまず、確率分布と統計的な推測について解説していきます。
確率変数と確率分布の意味
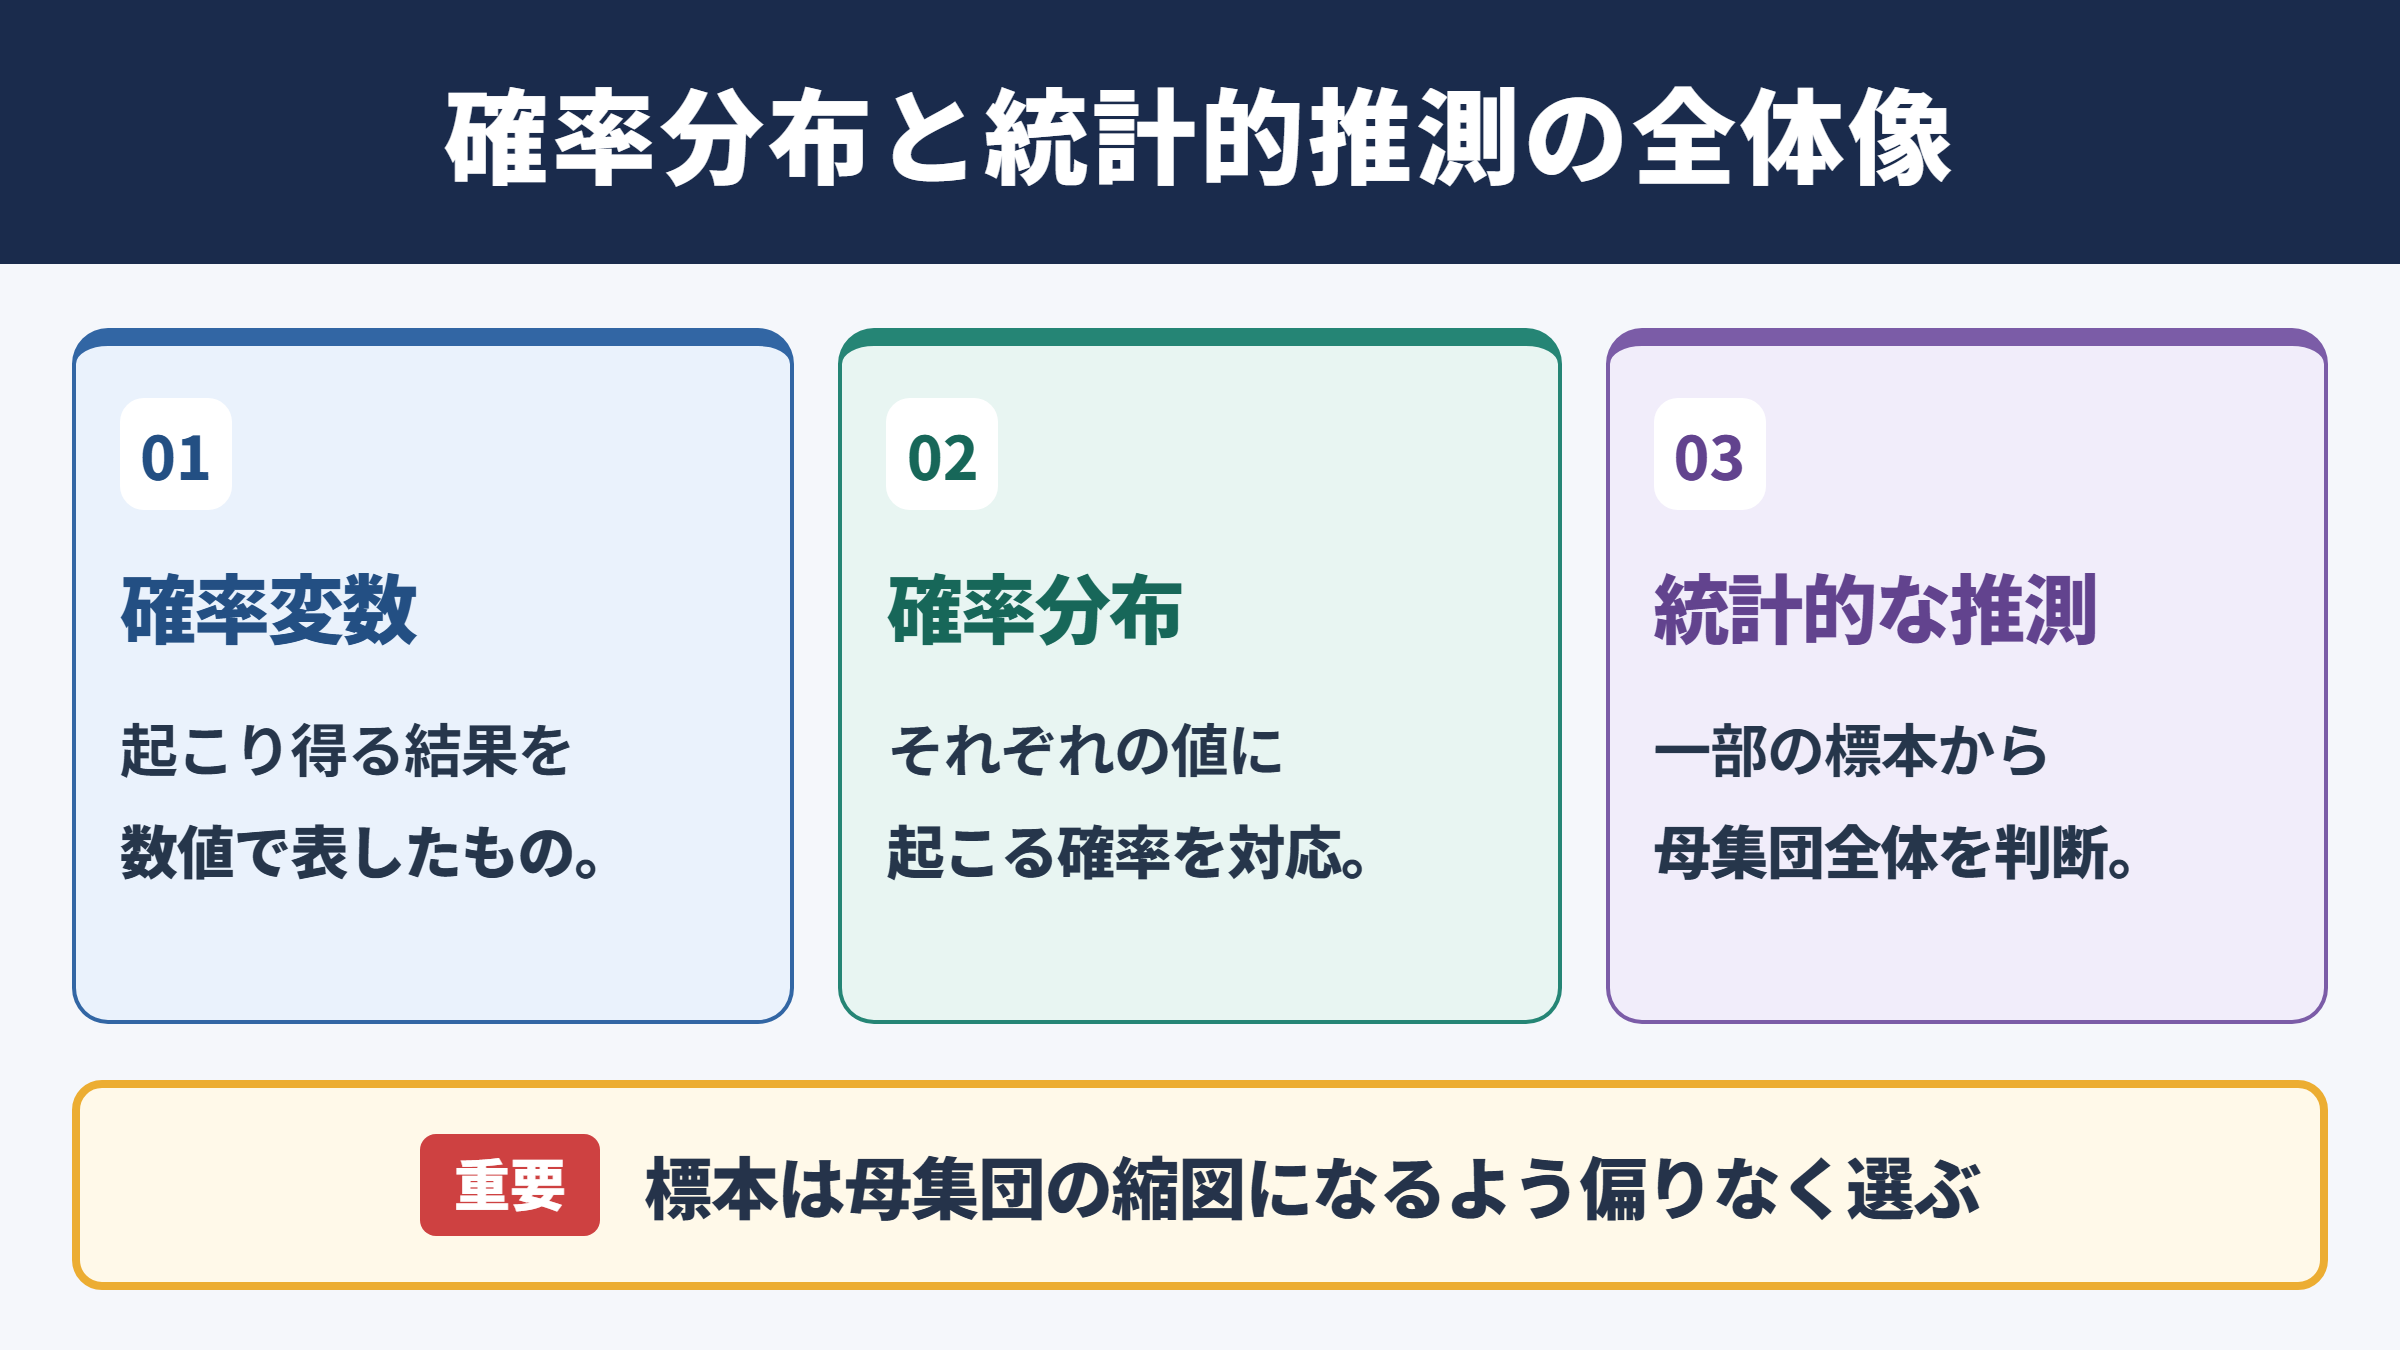
確率変数とは、起こり得る結果を数値で表したものです。
例えば、硬貨を3回投げて表が出る回数をXとすると、Xは0、1、2、3という値を取ります。
それぞれの値が出る可能性を対応させたものが確率分布です。
確率分布は、値そのものではなく、それぞれの値がどれくらい起こりやすいかを見る表と考えると理解しやすいでしょう。
硬貨を3回投げる場合、Xが0となる確率は8分の1、Xが1となる確率は8分の3、Xが2となる確率も8分の3、Xが3となる確率は8分の1です。
確率の合計は必ず1になります。
| 確率変数X | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 確率P(X=x) | 1/8 | 3/8 | 3/8 | 1/8 |
表を使うと、確率変数の取り得る値と確率の関係を整理できます。
問題では表を読み取る場面も、自分で表を完成させる場面もあるため、確率の合計が1かどうかを最後に確かめる習慣が役立ちます。
母集団と標本の関係
統計的な推測では、調べたい対象全体を母集団と呼びます。
全国の高校生の身長を調べたいなら、全国の高校生全員が母集団です。
しかし、全員を調査するには時間も費用もかかります。
そこで、母集団から一部を取り出して調べます。
この取り出したデータが標本であり、標本から得られた平均を標本平均といいます。
標本は母集団の縮図になるよう、偏りなく選ぶことが重要です。
特定の地域や年齢だけに調査対象が偏れば、得られた結果を母集団全体へ適切に広げられなくなります。
無作為抽出という考え方は、この偏りをできるだけ小さくするための方法です。
数学Bでの学習内容
数学Bでは、確率変数の平均、分散、標準偏差、二項分布、正規分布、標本分布、推定、仮説検定などを学びます。
前半では確率分布の形や数値的な特徴を扱い、後半では標本から母集団を判断する考え方へ進みます。
個別の公式を別々に覚えるよりも、確率分布を用いて不確実さを数値化し、その不確実さを考慮して判断する流れを意識するとよいでしょう。
確率分布は将来や偶然の結果のばらつきを表す道具です。
統計的な推測は、標本の結果から母集団について妥当な判断を行う考え方です。
この二つは、データ分析の基礎として連続した内容になっています。
確率変数の平均と分散の公式
続いては、確率変数の平均と分散の公式を確認していきます。
期待値としての平均
確率変数Xがx₁、x₂、x₃といった値を取り、それぞれの確率がp₁、p₂、p₃であるとします。
このとき、確率変数Xの平均は期待値とも呼ばれ、値と確率を掛けて合計することで求めます。
平均E(X)=x₁p₁+x₂p₂+x₃p₃+……
例えば、1から6までの目が同じ確率で出るさいころでは、平均は3.5です。
実際に1回振って3.5の目が出るわけではありません。
何度も繰り返したときの平均的な値が3.5に近づくという意味になります。
期待値は、実際に必ず出る値ではなく、長期的な平均を示す値です。
分散と標準偏差の計算
平均だけでは、データや確率変数がどれくらい散らばっているか分かりません。
そこで用いるのが分散です。
分散は、各値が平均からどれだけ離れているかを二乗して、その確率を掛けて合計した値です。
分散V(X)=E{X-E(X)}²
標準偏差σ=√V(X)
二乗する理由は、平均との差の正負が打ち消し合わないようにするためです。
標準偏差は分散の平方根であり、元のデータと同じ単位でばらつきを捉えられます。
例えば、点数の標準偏差が大きい集団は、平均点の周囲に点数が集まらず、成績の差が大きい傾向があります。
分散はばらつきの二乗、標準偏差はばらつきそのものの大きさとして区別しましょう。
一次式の平均と分散
確率変数Xに対して、Y=aX+bという新しい確率変数を作る問題も頻出です。
この場合、平均と分散には便利な公式があります。
E(aX+b)=aE(X)+b
V(aX+b)=a²V(X)
分散の式では、定数bを足しても分散は変わりません。
全ての値に同じ数を足しても、平均との差は変わらないためです。
一方で、a倍すると平均との差もa倍になり、その二乗を考える分散はa²倍になります。
符号が負であっても二乗されるため、分散は常に0以上です。
この違いを理解すると、計算問題で公式を取り違えにくくなります。
二項分布と確率計算の考え方
続いては、二項分布と確率計算の考え方を確認していきます。
二項分布が使える条件
二項分布は、成功と失敗のように二つの結果に分けられる試行を繰り返すときに用います。
硬貨の表裏、製品が合格か不合格か、くじが当たりか外れかといった場面が代表例です。
二項分布を使うためには、試行回数が決まっていること、各試行の成功確率が一定であること、試行が独立であることが必要です。
前の結果が次の結果に影響しない独立な試行かどうかを、まず確認しましょう。
復元抽出は独立な試行になりやすく、無作為に取り出して戻さない非復元抽出では、一般に成功確率が変化します。
二項分布の確率公式
成功確率がpの試行をn回繰り返し、成功回数をXとします。
Xがrとなる確率は、二項分布の公式で求められます。
P(X=r)=ₙCᵣpʳ(1-p)ⁿ⁻ʳ
ₙCᵣは、n回のうち成功するr回の場所を選ぶ組合せです。
pʳは成功するr回の確率、(1-p)ⁿ⁻ʳは失敗する回数の確率を表します。
例えば、表が出る確率が2分の1の硬貨を4回投げ、表が2回出る確率は、₄C₂×(1/2)²×(1/2)²となります。
計算すると6/16、すなわち3/8です。
二項分布の平均と分散
Xが二項分布B(n,p)に従うとき、平均と分散は次の公式で求められます。
E(X)=np
V(X)=np(1-p)
標準偏差=√np(1-p)
平均npは、n回の試行で期待される成功回数を示します。
成功確率が0.3の試行を10回行うなら、成功回数の平均は3回です。
ただし、実際の成功回数が必ず3回になるわけではありません。
平均は中心の目安であり、実際の結果のばらつきは分散や標準偏差で確認する必要があります。
二項分布の問題では、成功の定義を最初に決めることがポイントです。
成功は良い結果を意味する言葉ではなく、数えたい結果を表すための名称です。
正規分布と標準化の基礎
続いては、正規分布と標準化の基礎を確認していきます。
正規分布の特徴
正規分布は、平均を中心として左右対称の釣鐘形になる連続型の確率分布です。
身長、測定誤差、試験の得点など、多くのデータは条件によって正規分布に近い形を示すことがあります。
平均をμ、標準偏差をσとする正規分布をN(μ,σ²)と表します。
ここでσ²は分散です。
正規分布では、曲線と横軸で囲まれた面積が確率を表します。
離散的な値を扱う二項分布とは異なり、特定の一点を取る確率ではなく、ある範囲に入る確率を考える点が特徴です。
標準正規分布への変換
平均や標準偏差が異なる正規分布を比較するには、標準化を行います。
確率変数Xが平均μ、標準偏差σの正規分布に従うとき、Z=(X-μ)/σと変換したものは標準正規分布に従います。
Z=(X-μ)/σ
Zは平均0、標準偏差1の標準正規分布N(0,1)に従います。
標準化は、元の値が平均から標準偏差何個分だけ離れているかを表す操作です。
Zが2なら、元の値は平均より標準偏差2個分だけ大きいことを意味します。
標準正規分布表を使う問題では、求める範囲を図にしてから面積を考えると、引くべきか足すべきかを判断しやすくなります。
正規分布表の読み取り
標準正規分布表には、一般にP(0≦Z≦a)の値が載っています。
そのため、P(Z≦a)を求める場合は、0からaまでの面積に0.5を足します。
反対にP(Z≧a)なら、0.5から0からaまでの面積を引きます。
左右対称性を利用すると、負の値を含む範囲も整理できます。
標準正規分布では、P(Z≦-a)=P(Z≧a)という対称性が成り立ちます。
表の数字だけを機械的に使うのではなく、平均0を中心にした面積の位置を考えることが正答への近道です。
正規分布の確率は面積で判断します。
標準化、図示、分布表の参照という順序を守ると、複雑に見える問題も整理できます。
標本分布と統計的推測の方法
続いては、標本分布と統計的推測の方法を確認していきます。
標本平均の分布
母平均がμ、母標準偏差がσである母集団から、大きさnの無作為標本を取り出します。
標本平均をXバーとすると、Xバーも確率変数として扱えます。
標本平均の平均は母平均μに等しく、標準偏差はσ/√nです。
E(Xバー)=μ
標準偏差=σ/√n
標本の大きさnが大きくなるほど、標本平均のばらつきは小さくなります。
これは、多くのデータを平均するほど偶然の偏りがならされるためです。
標本数を4倍にしても標準偏差は半分になるだけという点は、公式の平方根に注目すると理解できます。
母平均の区間推定
区間推定は、母平均などの母数が入りそうな範囲を、信頼度とともに示す方法です。
母標準偏差が既知で、標本数が十分に大きい場合、信頼度95パーセントの母平均の信頼区間は次の形で表されます。
Xバー-1.96σ/√n≦μ≦Xバー+1.96σ/√n
1.96は標準正規分布で中央95パーセントに対応する値です。
信頼区間が狭いほど推定は精密ですが、標本数を増やしたり、ばらつきを小さくしたりする必要があります。
信頼度を高くすると、より確実に母平均を含みたいので区間は広くなります。
精度と確実さには、このような関係があります。
仮説検定の判断手順
仮説検定は、ある主張が標本データと矛盾しないかを確率にもとづいて判断する方法です。
まず、検証したい基準となる仮説を帰無仮説として置きます。
次に、その仮説が正しいと仮定した場合に、標本で得られた結果がどれほど起こりにくいかを調べます。
非常に起こりにくい結果なら、帰無仮説を棄却します。
起こりにくいとまではいえない場合は、帰無仮説を棄却しません。
棄却しないことは、仮説が完全に正しいと証明することではありません。
あくまで、その標本からは仮説を否定する十分な根拠が得られなかったという判断です。
統計的推測は、絶対的な断定をするための手法ではありません。
標本のばらつきや偶然性を考慮しながら、根拠の強さを判断するための手法です。
確率分布と統計的な推測のまとめ
最後に、確率分布と統計的な推測の要点をまとめます。
確率分布は、確率変数が取る値とその起こりやすさを表したものです。
平均は長期的な中心を示し、分散と標準偏差は値の散らばりを示します。
二項分布では成功回数を扱い、正規分布では連続的な量がある範囲に入る確率を面積として考えます。
標準化を使えば、平均や標準偏差が異なる正規分布でも同じ基準で確率を求められます。
統計的な推測では、母集団から抽出した標本を利用し、母平均の推定や仮説検定を行います。
公式を覚える際は、何を表す公式なのか、どのような条件で使えるのかまで一緒に確認することが重要です。
問題を解くときは、確率変数の定義、分布の種類、平均と標準偏差、求める確率の範囲を順に整理しましょう。
表や図を使って状況を可視化すれば、計算の意味が見えやすくなり、数学Bの確率分布と統計的な推測を確かな力として身につけられます。