EMアルゴリズムは、観測できない情報を含むデータから、確率モデルのパラメータを推定するための代表的な手法です。
特に混合正規分布では、各データがどのグループに属するかが不明なため、平均や分散を単純に計算するだけでは適切な推定につながりません。
そこで活用されるのが、潜在変数の期待値を求めるEステップと、推定値を更新するMステップを交互に繰り返す考え方です。
この記事では、EMアルゴリズムの意味、混合正規分布における推定手順、初期値の重要性、ベイズ推定との違い、例題の考え方までを順番に解説します。
EMアルゴリズムの基本的な役割
それではまず、EMアルゴリズムが混合正規分布の推定で果たす役割について解説していきます。
観測データと潜在変数の関係
EMアルゴリズムのEMは、Expectation Maximizationの頭文字を取った名称です。
日本語では期待値最大化法と呼ばれ、直接観測できない潜在変数を含むモデルの推定に向いています。
混合正規分布では、データ全体は観測できても、各データがどの正規分布から生成されたかは通常わかりません。
たとえば身長データに複数の集団が混ざっている場合、どの値がどの集団に由来するかをラベルなしで判断する必要があります。
この所属情報が潜在変数です。
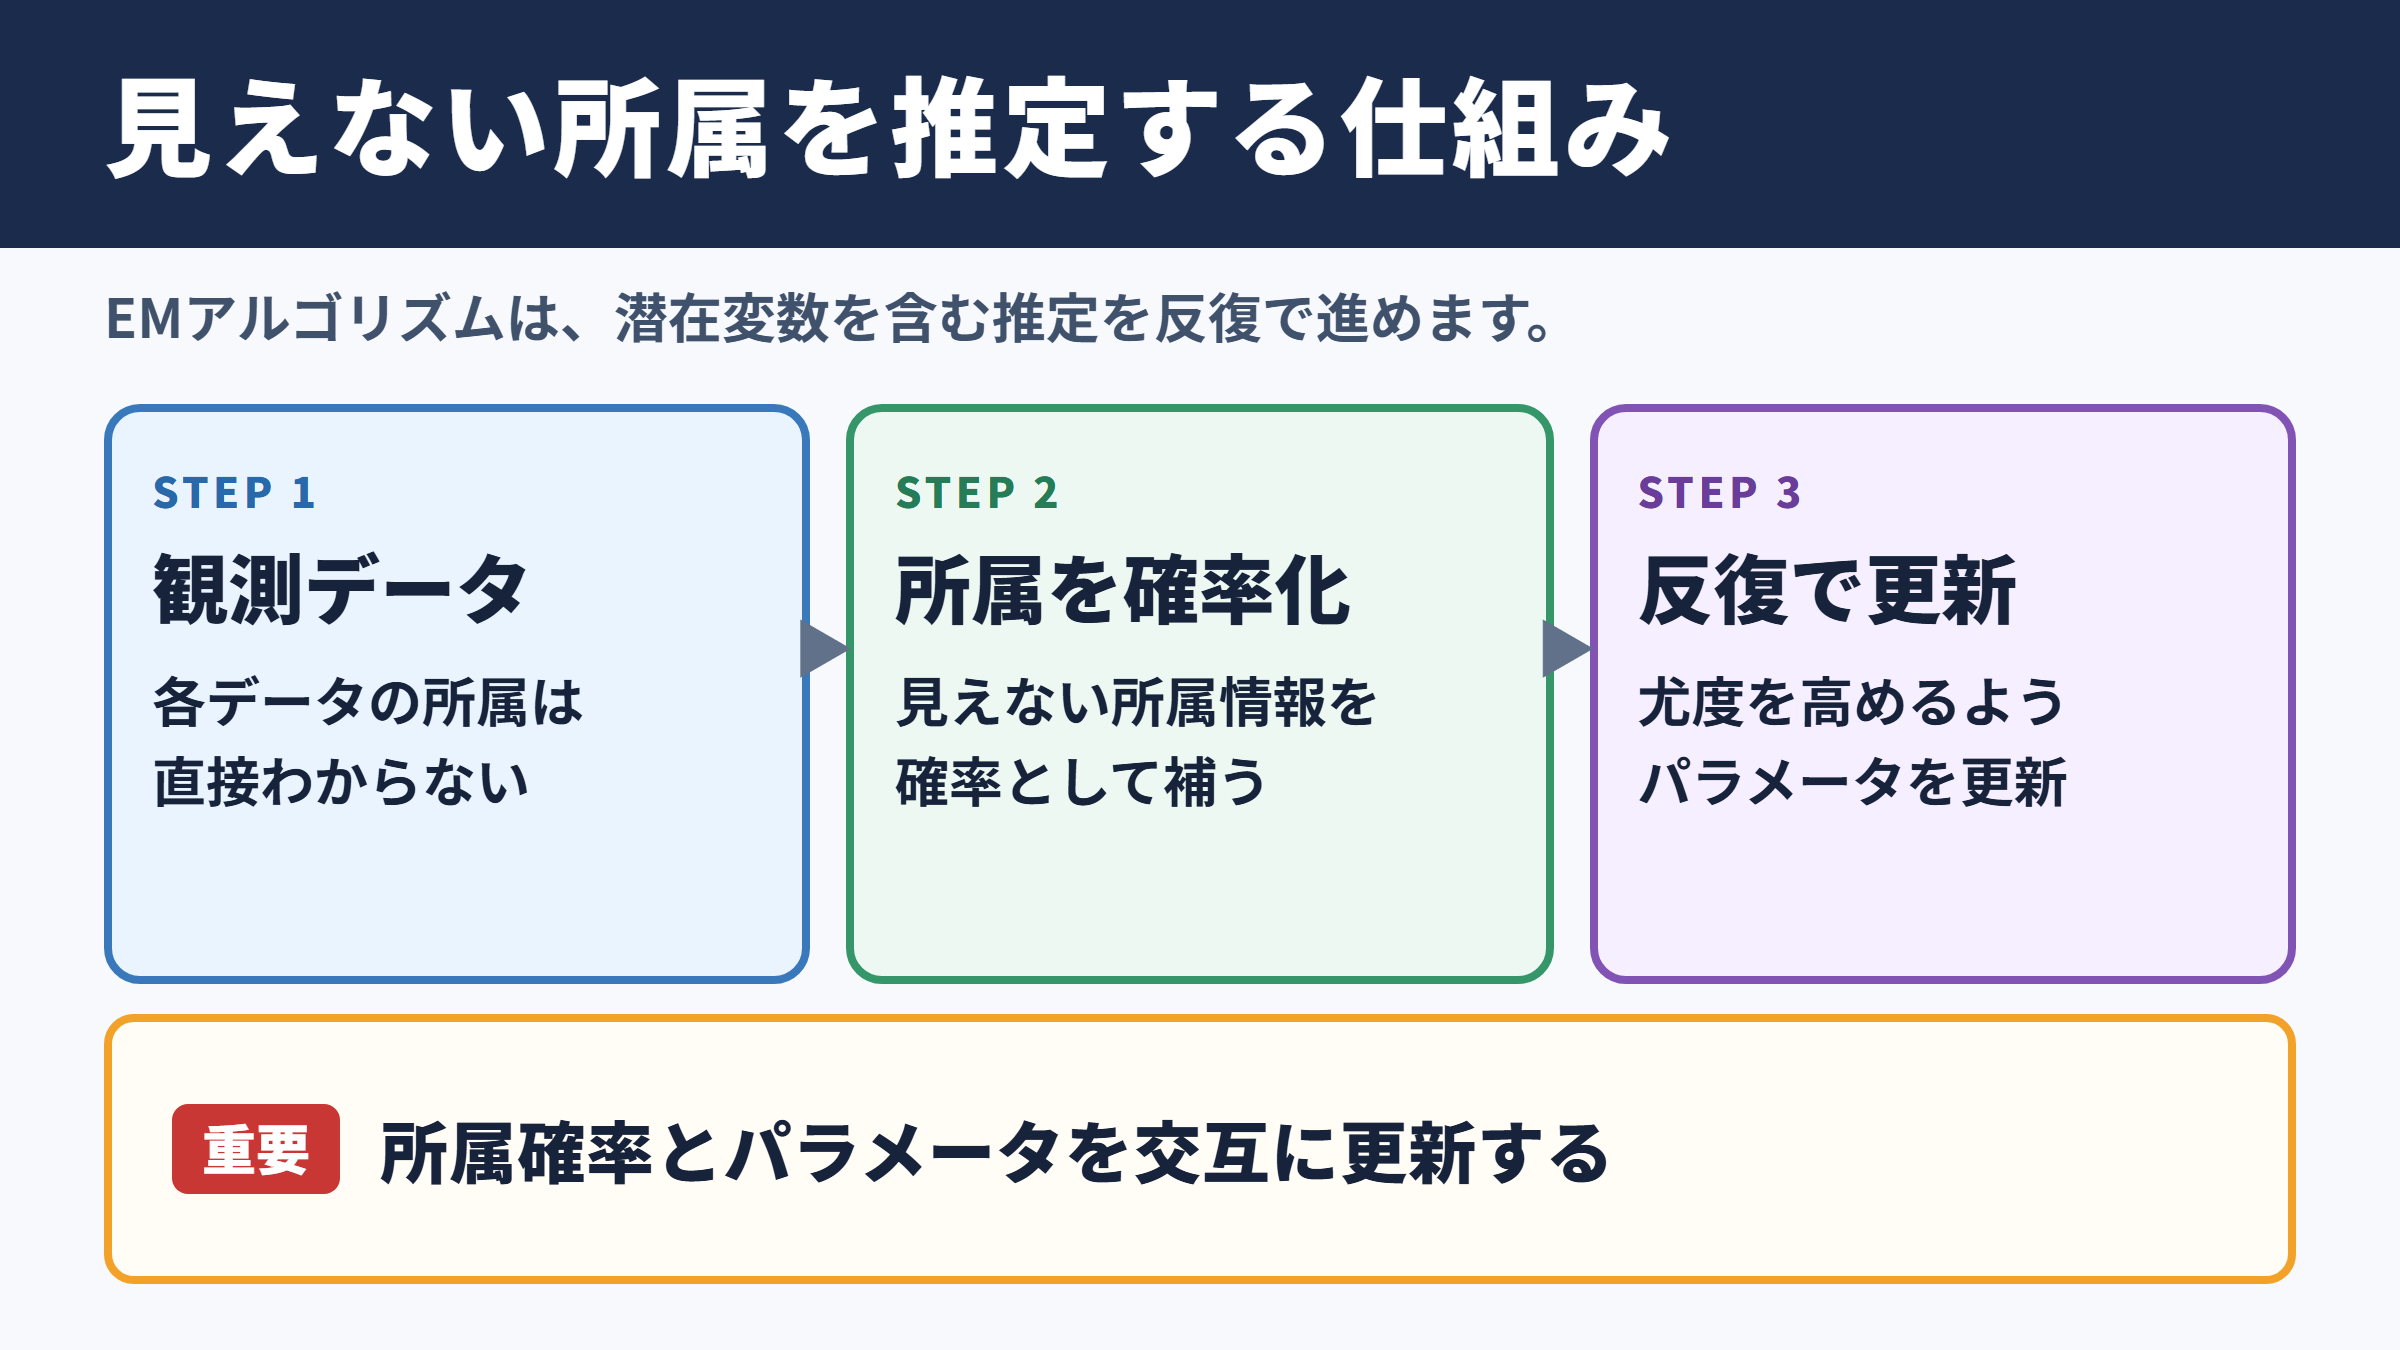
見えない所属情報を確率として補いながら推定を進める点が、EMアルゴリズムの大きな特徴といえるでしょう。
通常の最尤推定では、尤度関数を直接最大化できることが理想です。
しかし潜在変数を周辺化すると式が複雑になり、微分して解くことが難しいケースも少なくありません。
EMアルゴリズムは、この複雑な問題を扱いやすい二つの段階に分解します。
反復計算による尤度の改善
EMアルゴリズムは、一度の計算で最終解を出す方法ではありません。
仮のパラメータから始め、データの所属確率を計算し、その確率を利用してパラメータを更新します。
この流れを何度も反復することで、観測データに対する尤度を徐々に高めていきます。
尤度とは、設定した平均、分散、混合比が与えられたときに、実際のデータが観測されるもっともらしさを表す尺度です。
反復ごとに尤度が低下しにくい性質を持つため、推定過程を追いやすい点も実務上の利点です。
ただし、尤度が上がることと、必ず真のパラメータに到達することは同じではありません。
後ほど触れる初期値や局所解の問題があるため、結果を一度だけ確認して終えるのは注意が必要です。
EMアルゴリズムは、観測できない変数を仮定しながら、期待値の計算と尤度最大化を交互に行う推定手法です。
混合正規分布では、各データの所属確率を更新し続けることで、複数の分布の平均、分散、混合比を推定します。
混合正規分布で利用される場面
混合正規分布は、一つの正規分布だけでは説明しにくいデータに利用されます。
顧客の購買額を複数の行動層に分けたい場合、製造品の測定値から異なる生産条件の影響を探したい場合、画像データを色や特徴に応じてクラスタリングしたい場合などが代表例です。
医療統計や異常検知、音声認識、推薦システムでも、潜在的なグループ構造を扱う場面があります。
単なる分類ではなく、各データが各グループに属する確率まで扱える点が重要です。
たとえば、あるデータがグループAに完全に属すると決めるのではなく、Aに0.7、Bに0.3の確率で属すると表現できます。
曖昧な境界を確率で扱えることにより、現実の連続的なデータに適した分析が可能になります。
混合正規分布と潜在変数
続いては、混合正規分布の構造と潜在変数の意味を確認していきます。
複数の正規分布によるデータ表現
混合正規分布は、複数の正規分布を重ね合わせた確率分布です。
各正規分布には平均と分散があり、さらに全体の中でどの程度の割合を占めるかを示す混合比があります。
成分数をKとすると、各成分には平均μ、分散σの二乗、混合比πが設定されます。
混合比の合計は1になり、すべての成分が全体の確率を分担する形です。
混合正規分布の考え方は次のように表せます。
p(x) = Σ πk N(x|μk, σkの二乗)
ここでNは正規分布を表し、kは各成分を示します。
一つの山だけを持つ通常の正規分布に対し、混合正規分布は複数の山を表現できます。
そのため、平均値だけでは見えにくい集団の違いや、ばらつきの構造を捉えやすくなります。
所属を表す潜在変数
混合正規分布で重要になるのが、データの所属先を表す潜在変数です。
各観測値に対して、どの成分から発生したかを示すラベルを考えます。
ただし実際にはラベルが観測されないため、推定時には不明な情報として扱われます。
仮に二つの正規分布が混ざっている場合、各データには一つ目の成分に属するか、二つ目の成分に属するかという見えない状態があります。
EMアルゴリズムでは、この状態を0か1で決め打ちしません。
代わりに、現在のパラメータのもとで各成分に属する確率を計算します。
潜在変数を確率的に扱うため、境界付近のデータも無理なく反映できる仕組みです。
この所属確率は責務と呼ばれることがあります。
各成分があるデータをどれだけ説明する責任を持つか、と考えると理解しやすいでしょう。
混合比とパラメータの意味
混合比πは、各成分がデータ全体に占める比率を表します。
たとえば二成分モデルで混合比が0.6と0.4なら、モデル上では全体の約60パーセントが一つ目の成分、約40パーセントが二つ目の成分から生じると考えます。
ただし、これは単純な件数比ではありません。
所属確率を踏まえた重み付きの比率として更新されます。
| パラメータ | 意味 | 推定で確認する点 |
|---|---|---|
| 平均μ | 各成分の中心位置 | 集団の代表的な値 |
| 分散σの二乗 | 各成分の広がり | データのばらつき |
| 混合比π | 各成分の構成割合 | 集団の相対的な大きさ |
| 所属確率 | 各データの成分への適合度 | 曖昧な境界の扱い |
平均だけを比べる分析と異なり、分散や混合比も同時に推定するため、データの構造をより立体的に読み取れます。
EステップとMステップ
続いては、EMアルゴリズムの中心となる二つの計算手順を確認していきます。
Eステップにおける所属確率
Eステップでは、現在のパラメータを使い、各データが各成分に属する確率を求めます。
ここで計算されるのは、観測値を見たあとにおける所属先の確率です。
ベイズの定理に近い考え方で、混合比と各成分の確率密度を組み合わせて算出します。
データxiが成分kに属する確率は、概念的には次の形です。
γik = πk N(xi|μk, σkの二乗) ÷ Σ πj N(xi|μj, σjの二乗)
分子は成分kがxiを説明する強さであり、分母は全成分を合わせた説明の強さです。
ある成分の平均に近く、分散の範囲にも収まるデータは、その成分に対する所属確率が高くなります。
逆に複数の成分の中間に位置するデータは、確率が分散するでしょう。
Eステップはパラメータそのものを変える段階ではなく、現在の仮説に基づいてデータの説明を整理する段階です。
Mステップにおけるパラメータ更新
Mステップでは、Eステップで得た所属確率を重みとして利用し、平均、分散、混合比を更新します。
所属確率が高いデータほど、その成分の平均や分散に大きく反映されます。
完全に所属を決めるハードクラスタリングとは異なり、すべてのデータが重み付きで各成分の推定に参加する点が特徴です。
平均は所属確率による加重平均として計算されます。
分散は更新後の平均からの距離を、同じく所属確率で重み付けして求めます。
混合比は各成分に割り当てられた責務の合計を、データ数で割ることで更新されます。
この処理により、モデルは観測データにより適合する方向へ調整されます。
Mステップでは、所属確率を重みとした平均、分散、混合比の再計算を行います。
各データを一つのグループに固定しないため、境界にある観測値の情報も推定に活かせます。
収束判定と繰り返し回数
EステップとMステップは、尤度の変化が十分に小さくなるまで繰り返します。
実装では、前回と今回の対数尤度の差が指定した閾値未満になった場合に収束と判断する方法が一般的です。
反復回数の上限も設定し、計算が長く続きすぎる状況を避けます。
収束したとしても、結果の妥当性は別途確認する必要があります。
平均が極端な値になっていないか、分散が不自然に小さくなっていないか、混合比がほぼゼロの成分がないかを点検しましょう。
収束は計算終了の目安であり、モデルの正しさを保証する印ではありません。
可視化や複数の初期値による比較を組み合わせると、推定結果の信頼性を高めやすくなります。
初期値と局所解
続いては、推定精度を左右する初期値と局所解の関係を確認していきます。
初期値が結果に与える影響
EMアルゴリズムは反復的に尤度を改善しますが、任意の初期値から同じ解に到達するとは限りません。
混合正規分布の尤度関数には、複数の山が存在する場合があります。
そのため、初期値の置き方によっては、最も望ましい解ではなく局所的に高い解へ収束することがあります。
平均の初期値が近すぎると、異なる成分が似た位置に集まり、グループを十分に分離できない可能性があります。
一方で、極端に離れた初期値も、データに合わない推定を招く場合があります。
初期値は単なる計算開始点ではなく、最終的なクラスタリング結果に影響する重要な設定です。
分析目的に沿った初期化を選ぶことが、安定した推定の第一歩になります。
代表的な初期化の方法
もっとも単純な方法は、平均、分散、混合比を乱数で初期化する方法です。
複数回試行し、最も対数尤度が高い結果を採用すれば、偶然の偏りを抑えやすくなります。
より実用的な方法として、K平均法の結果を初期値に使う方法があります。
K平均法で得たクラスタ中心を混合正規分布の平均の初期値に設定し、各クラスタ内のばらつきから分散を設定します。
データに一定の構造がある場合には、乱数だけよりも収束が安定しやすい傾向があります。
| 初期化の方法 | 特徴 | 注意点 |
|---|---|---|
| 乱数による初期化 | 手軽で実装しやすい | 複数回の試行が必要 |
| K平均法の利用 | データ構造を反映しやすい | クラスタ数の設定が必要 |
| 知識に基づく設定 | 業務上の仮説を反映できる | 主観的な偏りに注意 |
| 複数手法の比較 | 安定性を確認しやすい | 計算時間が増える |
局所解と特異解への対策
局所解とは、近傍では尤度が高いものの、全体で最も高い尤度を持つ解ではない状態です。
EMアルゴリズムは尤度を改善する方向に進みますが、低い谷を越えて別の山へ移動する仕組みは基本的に持ちません。
このため、異なる初期値から複数回実行し、対数尤度、パラメータ、クラスタの解釈を比較することが大切です。
また、ある成分の分散が極端にゼロへ近づく特異解にも注意が必要です。
一つの観測値だけに成分が集中すると、確率密度が非常に大きくなり、数値計算が不安定になることがあります。
分散に下限を設ける、正則化を加える、共分散行列に小さな値を足すといった対策が有効です。
初期値を変えた複数回の実行は、EMアルゴリズムの実務ではほぼ必須の確認作業です。
最終尤度だけで決めず、各成分の平均、分散、混合比が分析目的に照らして自然かどうかも確認しましょう。
ベイズ推定と例題
続いては、ベイズ推定との関係と、混合正規分布を使った例題の考え方を確認していきます。
最尤推定としてのEMアルゴリズム
標準的なEMアルゴリズムは、観測データの尤度を最大化する最尤推定の手法として理解できます。
パラメータは固定値として扱い、その値のもとでデータが最も起こりやすくなるように平均、分散、混合比を調整します。
データ数が多く、モデル設定が適切な場合には、最尤推定は強力な方法です。
一方で、データが少ない場合や、成分数が多い場合には、推定値が不安定になることがあります。
分散が過度に小さくなったり、混合比が極端になったりする問題も起こり得ます。
最尤推定はデータだけを中心に考えるため、事前の知識を直接取り込まない点を押さえておくと、ベイズ推定との違いが見えやすくなります。
ベイズ推定との違い
ベイズ推定では、パラメータ自体にも確率分布を設定します。
たとえば平均には正規分布、分散には逆ガンマ分布、混合比にはディリクレ分布のような事前分布を置くことがあります。
観測データと事前分布を組み合わせることで、パラメータの事後分布を求めるのがベイズ推定の考え方です。
EMアルゴリズムとベイズ推定は対立する方法ではありません。
事前分布を加えた最大事後確率推定では、EMアルゴリズムに近い反復計算の枠組みを利用できる場合があります。
ベイズ的な考え方を取り入れると、少量データでの過度な推定を抑えたり、既存の知識を反映したりしやすくなります。
最尤推定は、データの尤度を最大にするパラメータを探します。
ベイズ推定は、データの尤度と事前分布を組み合わせて、パラメータの不確実性も扱います。
目的が点推定なのか、不確実性を含めた判断なのかで選択が変わります。
二成分混合正規分布の例題
ここでは、二つの集団が混在する一次元データを考えます。
仮に小さめの値が集まるグループと、大きめの値が集まるグループがあり、どのデータがどちらに属するかは不明とします。
最初に、二つの平均、二つの分散、二つの混合比を仮置きします。
次にEステップで、各データについて一つ目と二つ目の成分への所属確率を計算します。
平均に近いデータはその成分への確率が高くなり、中間のデータは両方に確率が割り振られます。
Mステップでは、その所属確率を重みに平均と分散を更新します。
この処理を繰り返すと、それぞれの成分がデータの山に対応する位置へ移動していきます。
例題では計算式だけでなく、反復ごとに平均と混合比がどう変化するかを追うことが理解への近道です。
最終結果では、各データの所属確率を一覧にし、どの観測値が判断の境界にあるかを確認するとよいでしょう。
まとめ
EMアルゴリズムは、潜在変数を含む確率モデルのパラメータを推定するための反復計算手法です。
混合正規分布では、各データの所属先が不明なため、Eステップで所属確率を求め、Mステップで平均、分散、混合比を更新します。
Eステップは見えない所属を確率として補い、Mステップはその確率を重みとしてモデルを更新する処理と整理すると理解しやすいでしょう。
EMアルゴリズムは尤度を改善しながら収束しますが、初期値によって局所解に到達する可能性があります。
乱数やK平均法を使った複数の初期化、対数尤度の比較、分散の下限設定などを組み合わせることが大切です。
また、最尤推定として使うだけでなく、事前分布を取り入れるベイズ的な推定との関係を理解すると、少量データや不確実性を扱う場面にも応用の幅が広がります。
混合正規分布の推定では、数式の意味、データの可視化、結果の解釈を一緒に確認しながら進めることで、EMアルゴリズムを実践的に活用できます。