アルゴリズムとは?意味や基本的な仕組みをわかりやすく解説!
検索エンジン、スマートフォンのアプリ、ネット通販のおすすめ表示、銀行の送金処理など、私たちの身近なサービスは多くのアルゴリズムによって動いています。
言葉だけを聞くと難しく感じるかもしれませんが、アルゴリズムは目的を達成するための手順を整理した考え方です。
プログラミングを始める人だけでなく、業務改善やデータ分析に関わる人にとっても、仕組みを理解する価値は大きいでしょう。
この記事では、アルゴリズムの意味から基本的な種類、設計時の考え方、日常生活やビジネスでの活用例まで、順を追って解説します。
アルゴリズムの意味と基本的な役割
それではまず、アルゴリズムの意味と基本的な役割について解説していきます。
目的達成までの手順
アルゴリズムとは、ある問題を解決したり、目標を達成したりするための、明確な手順の集合です。
料理であれば材料を切り、加熱し、味付けをして盛り付ける流れがあり、これも広い意味ではアルゴリズムとして考えられます。
コンピューターは人間のように曖昧な判断を得意としていないため、何をどの順番で行うかを具体的に指示する必要があります。
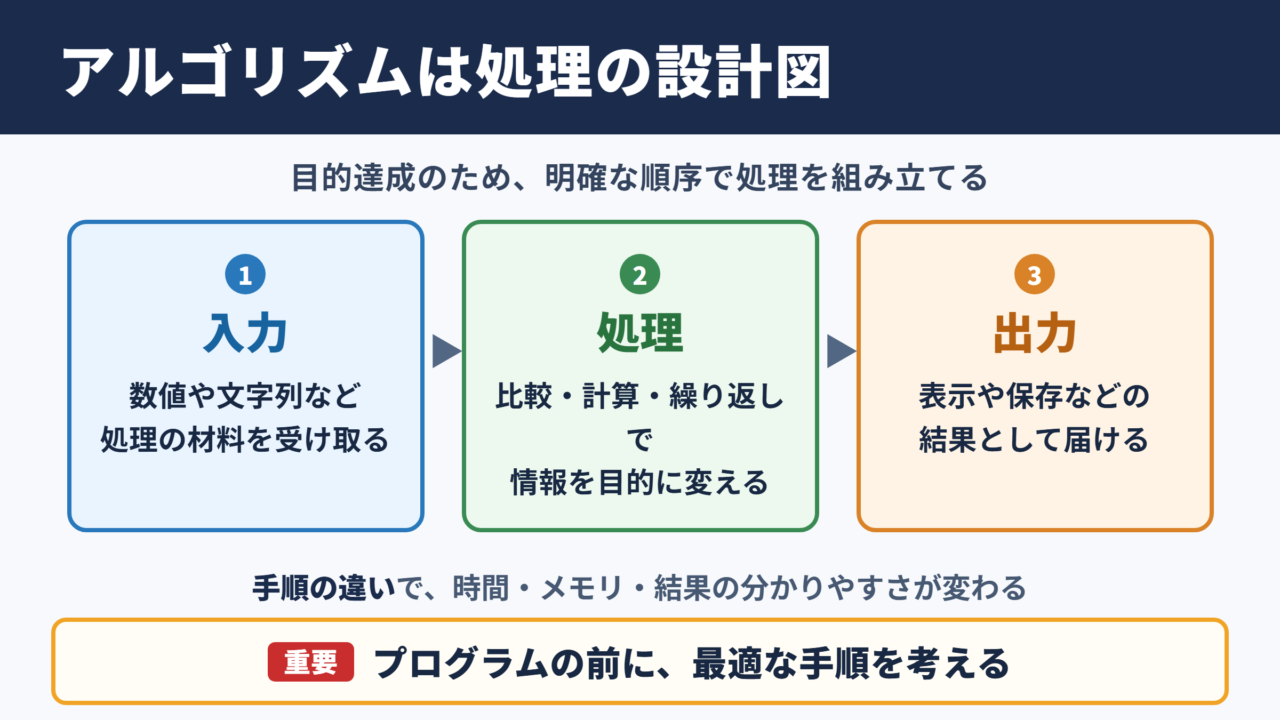
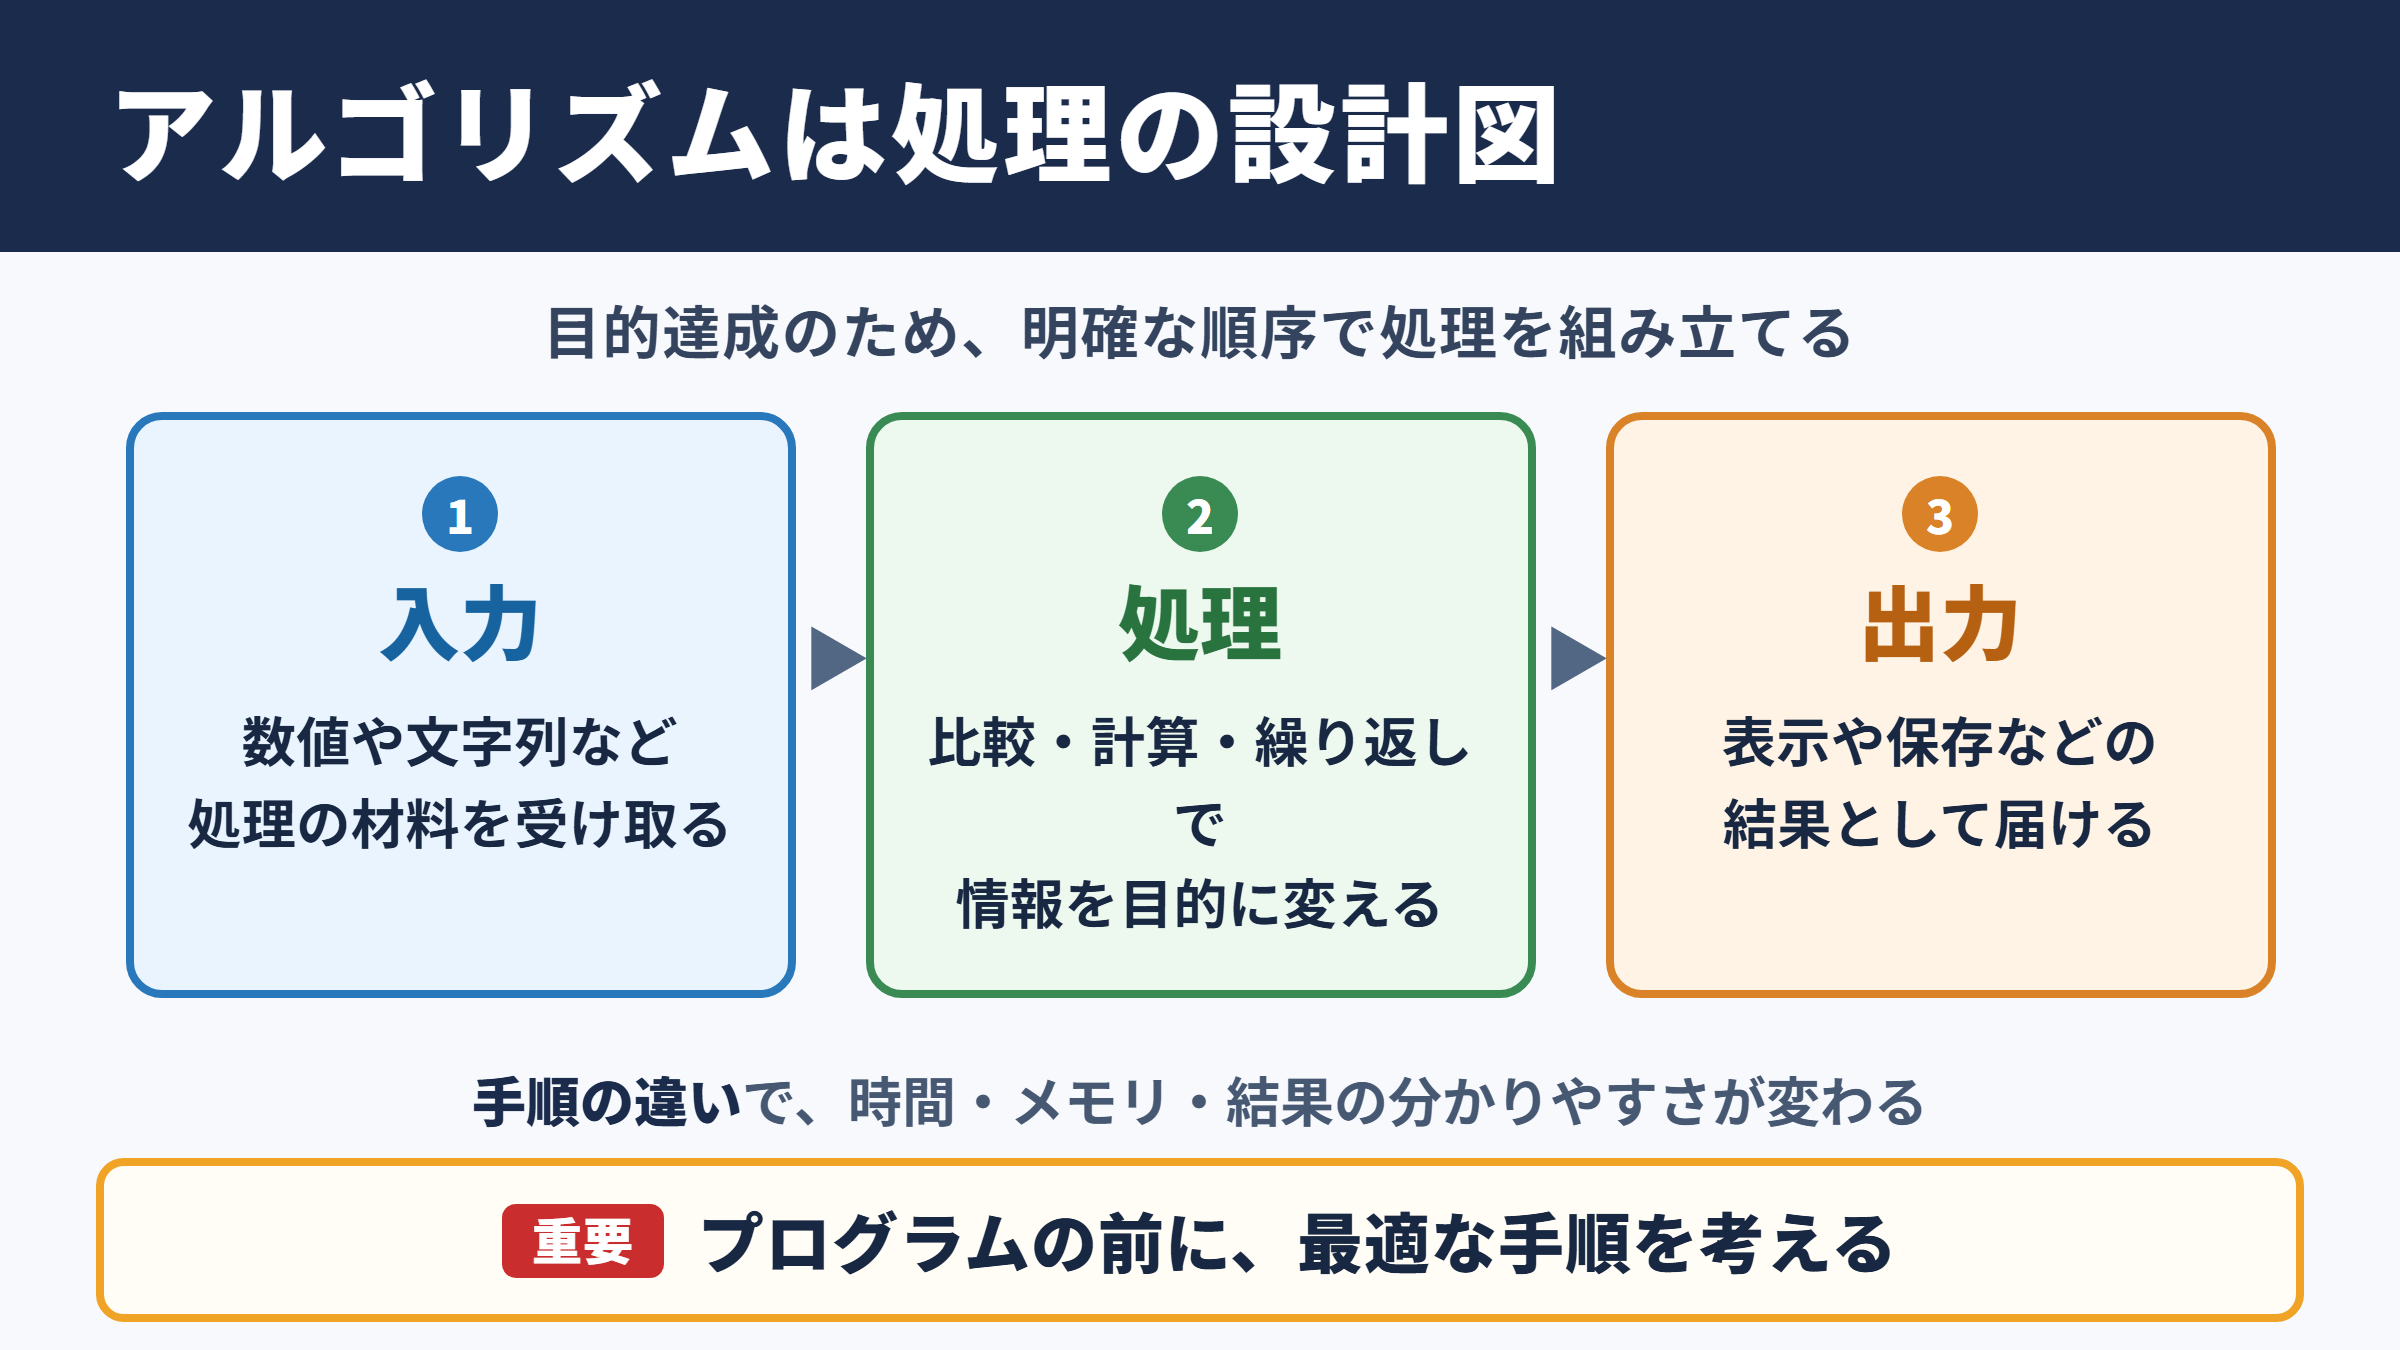
そこで重要になるのが、入力された情報を受け取り、決められた処理を実行し、結果を出力するという一連の手順です。
アルゴリズムはプログラムそのものではなく、プログラムを作る前に考える処理の設計図と捉えると理解しやすくなります。
同じ目的を持つ処理でも、手順の組み立て方によって、処理時間、必要なメモリ、結果のわかりやすさが変わります。
たとえば大量の商品から条件に合う商品を探す場合、1件ずつ確認する方法もありますが、並び順や分類を利用すれば、より少ない回数で見つけられることがあります。
このように、限られた時間や計算資源の中で適切な答えを導くための工夫が、アルゴリズムの本質です。
入力と処理と出力
多くのアルゴリズムは、入力、処理、出力という3つの要素で整理できます。
入力とは、処理の材料になる数値、文字列、画像、利用者の操作履歴などの情報です。
処理では、条件分岐、繰り返し、比較、計算、並べ替えといった操作を組み合わせ、目的に合う形へ情報を変換します。
出力は、画面への表示、ファイルの保存、検索結果、予測値、ロボットへの動作指示など、処理後に得られる結果を指します。
入力が注文金額と会員ランクで、処理が割引条件の判定で、出力が支払金額である場合を考えます。
注文金額が一定額以上なら割引率を適用し、会員ランクが上位ならさらに特典を加えるという順序を決めれば、会計処理のアルゴリズムになります。
ここで大切なのは、誰が実行しても同じ条件なら同じ結果になるよう、判断基準を明確にすることです。
条件が曖昧なままでは、開発者によって解釈が分かれたり、予期しない処理漏れが発生したりします。
入力に誤りがあった場合の対応や、該当する条件がない場合の処理も、あらかじめ手順に含める必要があります。
正常なケースだけでなく、例外的なケースまで想定することが、実用的なアルゴリズム設計につながります。
プログラムとの違い
アルゴリズムとプログラムは関連が深い言葉ですが、同じ意味ではありません。
アルゴリズムは問題を解くための論理的な手順であり、プログラムはその手順をPython、JavaScript、Javaなどのプログラミング言語で記述した実装です。
たとえば、連絡先を名前順に並べるという考え方はアルゴリズムであり、それをスマートフォン上で動作するコードに変換したものがプログラムです。
アルゴリズムが適切に考えられていなければ、どれほど新しい言語を使っても、処理が遅い、誤りが起きる、変更しにくいといった問題が残ります。
反対に、処理の流れが整理されていれば、利用する言語や実行環境が変わっても考え方を応用しやすくなります。
そのため、開発の現場ではコードを書き始める前に、処理の流れを文章、図、擬似コード、フローチャートなどで確認する場面が少なくありません。
アルゴリズムは解決方法の筋道であり、プログラムはその筋道をコンピューターが実行できる形にしたものです。
この違いを押さえると、技術用語への苦手意識を減らしながら、システムの仕組みを理解しやすくなります。
アルゴリズムを構成する基本要素
続いては、アルゴリズムを構成する基本要素を確認していきます。
順次処理
順次処理は、上から下へ、決められた順番に処理を進める最も基本的な構造です。
ログイン画面でメールアドレスを受け取り、パスワードを受け取り、入力内容を確認し、認証結果を表示する流れは、順次処理のわかりやすい例です。
単純な構造に見えても、処理の前後関係を守るために欠かせません。
先に必要な情報を準備しなければ次の計算ができない場合、順番を入れ替えるだけでエラーや誤った結果が起こる可能性があります。
業務手順を自動化する際も、申請内容の取得、条件確認、承認者への通知、記録の保存という順序を明確にすることで、担当者間の認識のずれを抑えられます。
順次処理は当たり前の流れに見えるからこそ、抜け漏れや順序の誤りを丁寧に確認することが重要です。
条件分岐
条件分岐は、ある条件が成立するかどうかによって、その後の処理を変える仕組みです。
年齢が18歳以上なら申し込みを受け付ける、在庫があれば注文を確定する、パスワードが一致しなければ再入力を求めるといった処理に利用されます。
条件分岐では、条件そのものだけでなく、成立した場合と成立しなかった場合の両方を設計する必要があります。
とくに複数の条件が重なる場面では、優先順位を誤ると本来とは異なる判定になるため注意が必要です。
| 判定条件 | 処理内容 | 確認すべき点 |
|---|---|---|
| 在庫あり | 注文を受け付ける | 予約在庫を含めるか |
| 在庫なし | 入荷通知を案内する | 代替商品の提示有無 |
| 住所不備 | 入力画面へ戻す | エラー表示のわかりやすさ |
| 決済エラー | 別の支払い方法を案内する | 二重請求の防止 |
表のように、利用者の操作やデータの状態に応じた分岐を洗い出すと、必要な処理を整理しやすくなります。
条件が増えるほど全体像は複雑になるため、似た判定をまとめたり、優先順を文章で明文化したりする工夫が求められます。
繰り返し処理
繰り返し処理は、同じ操作を一定回数、または条件を満たすまで続ける構造です。
会員一覧の全員にメールを送る処理、売上データを月ごとに集計する処理、パスワード入力を成功するまで受け付ける処理などに活用されます。
人が同じ作業を何百回も繰り返すと、時間がかかるだけでなく、入力ミスや確認漏れも起こりやすくなります。
繰り返し処理を適切に設計すれば、同じルールを大量のデータに一貫して適用できます。
ただし、終了条件を誤ると処理が終わらない状態になるため、何を満たしたら繰り返しを終了するのかを明確にしなければなりません。
たとえば、未処理データがなくなるまで続ける場合は、1回の処理ごとに未処理件数が減っているかを確認できる仕組みが必要です。
繰り返し処理では、開始条件、実行内容、終了条件の3点をセットで考えると、安定した設計になりやすいでしょう。
代表的なアルゴリズムの種類
続いては、代表的なアルゴリズムの種類について解説していきます。
探索アルゴリズム
探索アルゴリズムは、多数のデータの中から、目的の情報を見つけ出すための手順です。
図書館の蔵書検索、通販サイトの商品検索、社内システムでの顧客情報検索など、多くの場面で使われています。
最も基本的な方法は、先頭から順にデータを確認する線形探索です。
データ数が少ない場合や、並び順が決まっていない場合には扱いやすい方法ですが、件数が増えるほど確認回数が多くなります。
一方、データがあらかじめ昇順や降順に並んでいる場合は、中央の値と比較しながら対象範囲を半分ずつ絞る二分探索が利用できます。
1から100までの番号が順に並んでいる中から73を探す場合、先頭から確認すると最大で73回の比較が必要になることがあります。
二分探索なら、中央付近の50と比較し、次に75、その後に62というように範囲を絞れるため、比較回数を大きく減らせます。
ただし二分探索を使うためには、データが一定の規則で整列していることが前提です。
検索速度だけでなく、データを並べ替える手間、更新頻度、保存形式も考慮しながら、適切な探索方法を選ぶ必要があります。
整列アルゴリズム
整列アルゴリズムは、数値、日時、文字列などのデータを、決められた順序に並べ替える手順です。
売上を高い順に表示する、投稿を新着順に表示する、受験者を得点順に並べるといった機能の基盤になります。
代表的なものには、隣り合う要素を比較して入れ替えるバブルソート、基準となる値を使ってグループを分けるクイックソート、複数の並びを統合するマージソートなどがあります。
小さなデータでは単純な方法でも問題になりにくい一方、数万件や数百万件のデータを扱う場合は、手順の違いが処理時間に大きく影響します。
また、同じ値を持つデータの順序を維持する必要があるか、メモリをどの程度使えるか、データがほぼ整列済みかといった条件によって、適した方法は変わります。
整列は表示順を整えるだけの処理ではなく、その後の検索や集計を効率化するための重要な準備でもあります。
最適化アルゴリズム
最適化アルゴリズムは、複数の選択肢の中から、時間、費用、距離、利益などの条件において、より望ましい解を探すための手順です。
配送ルートの決定、広告予算の配分、工場の生産計画、座席予約の割り当てなど、ビジネスの現場でも幅広く使われています。
最適化では、必ずしも唯一の正解を瞬時に見つけられるとは限りません。
選択肢が極端に多い問題では、すべての組み合わせを確認すると時間がかかりすぎるため、十分に良い解を短時間で探す考え方が採用されることもあります。
たとえば最短経路を求める場面では、距離だけでなく、渋滞、通行止め、配送時間帯、車両の積載量なども条件に加わるでしょう。
そのため、何を最優先にするのかを明確にすることが、最適化アルゴリズムを活用する第一歩になります。
最適な答えは、常に最も速い答えや最も安い答えだけを意味するわけではありません。
利用者満足、品質、リスク、運用のしやすさを含めて、目的に合う評価基準を定めることが欠かせません。
アルゴリズムの性能を判断する考え方
続いては、アルゴリズムの性能を判断する考え方を確認していきます。
計算量の目安
アルゴリズムの性能を考える際には、どれくらいの処理回数が必要になるかを表す計算量という考え方が用いられます。
データ件数を増やしたときに、処理時間がどの程度増えるかを予測するための目安です。
一般に、データ数に比例して処理量が増える場合は比較的扱いやすく、データ数の2乗に比例する場合は件数が増えたときに負荷が大きくなりやすい傾向があります。
たとえば100件のデータなら問題が目立たなくても、1万件になった途端に応答が遅くなるケースがあります。
性能問題を避けるには、現在のデータ量だけでなく、数年後にどれくらい増える可能性があるかも想定して設計することが大切です。
小規模では十分に見える処理でも、利用者やデータが増えたときの負荷を考える視点が必要です。
時間効率とメモリ効率
アルゴリズムの良し悪しは、処理時間だけで決まりません。
処理中にどれだけのメモリを使うかも、重要な評価項目です。
大量のデータを一度に読み込めば処理を速くできる場合がありますが、必要なメモリが増え、端末やサーバーに負担がかかることがあります。
反対に、メモリ使用量を抑えようとすると、何度もデータを読み直す必要が生じ、処理時間が長くなることもあるでしょう。
このように、時間効率とメモリ効率にはトレードオフが存在します。
リアルタイム性が求められる決済処理、端末性能が限られるスマートフォンアプリ、大規模な分析基盤では、優先すべき条件が異なります。
利用環境と目的を整理したうえで、どの資源を優先するかを判断することが現実的です。
正確性と保守性
高速なアルゴリズムでも、誤った結果を返したり、変更に対応しにくかったりすれば、実務では使い続けにくくなります。
そのため、想定した入力に対して正しい出力を返す正確性、仕様変更に対応しやすい保守性も重要です。
税率、送料、キャンペーン条件のように将来変更されやすい要素を、処理のあちこちに直接書き込むと、修正漏れの原因になります。
条件をまとめて管理し、処理ごとの役割を分けることで、後からの確認や修正がしやすくなります。
また、第三者が読んでも理解できる名前を使い、複雑な処理は小さな単位に分けると、障害の原因調査も進めやすくなります。
優れたアルゴリズムは速さだけでなく、正しく動き続け、将来も直しやすいことが特徴です。
性能を確認するときは、通常のデータだけでなく、データが空の場合、同じ値が連続する場合、想定より大きな値が入る場合も試します。
境界条件や例外入力を検証することで、実際の運用で起こりやすい不具合を早めに見つけやすくなります。
日常生活とビジネスにおける活用場面
続いては、日常生活とビジネスにおける活用場面を見ていきます。
検索エンジンとおすすめ表示
検索エンジンでは、利用者が入力したキーワードに対し、大量のウェブページから関連性の高い情報を探し、順番を付けて表示するためにアルゴリズムが使われています。
単にキーワードが含まれているかだけでなく、ページの内容、情報の新しさ、利用者にとっての役立ちやすさ、関連する語句など、さまざまな要素が考慮されます。
動画配信サービスや通販サイトのおすすめ表示でも、閲覧履歴、購入履歴、評価、似た行動を取る利用者の傾向などを参考に、候補を提示する仕組みが使われます。
これにより利用者は膨大な選択肢の中から、自分に関係のありそうな情報を見つけやすくなります。
一方で、おすすめに偏りが生じる可能性もあるため、表示結果を絶対的なものとして受け取らず、複数の情報源を確認する姿勢も大切でしょう。
業務自動化とデータ分析
企業では、請求書の照合、在庫補充、問い合わせの振り分け、勤怠集計、売上予測など、繰り返し発生する業務にアルゴリズムが活用されています。
定型作業のルールを整理して自動化すれば、担当者は単純な転記作業から離れ、顧客対応や企画立案など、人の判断がより活きる業務に時間を使いやすくなります。
データ分析では、売上の変化を集計したり、顧客を特徴ごとに分類したり、将来の需要を予測したりするために多様なアルゴリズムが使われます。
ただし、入力データに偏りや誤りがあれば、処理手順が優れていても結果の信頼性は下がります。
アルゴリズムの活用では、処理方法だけでなく、元になるデータの品質と運用ルールが同じくらい重要です。
導入前には、何を改善したいのか、誰が結果を確認するのか、例外が起きたときにどう対応するのかを整理しておくとよいでしょう。
人工知能との関係
人工知能とアルゴリズムは密接に関係していますが、意味は異なります。
人工知能の仕組みでも、データを学習し、特徴を見つけ、予測や分類を行うために、多くのアルゴリズムが使われています。
画像から物体を判定する、文章を要約する、音声を文字に変換する、需要を予測するといった機能は、データと学習方法、評価方法を組み合わせて実現されます。
従来のルールベースの処理では、人が条件を細かく決めることが多いのに対し、機械学習では大量のデータから判断の傾向を学ぶ方法が用いられます。
ただし、人工知能が出した結果にも誤りや偏りが含まれる可能性があります。
重要な意思決定に使う場合は、結果の根拠を確認し、人が最終判断する体制を整えることが欠かせません。
アルゴリズムは便利な自動化の土台ですが、目的設定、データの扱い、結果の確認まで含めて設計してこそ、安全で役立つ仕組みになります。
技術だけに任せず、人の判断と責任の置き場所を明確にすることが重要です。
アルゴリズム理解のための学習手順
続いては、アルゴリズム理解のための学習手順について解説していきます。
身近な手順への置き換え
初めて学ぶ場合は、難しい数式や専門用語から入るより、身近な作業を手順に分解するところから始める方法がおすすめです。
たとえば、朝の準備、メールの返信、買い物リストの作成、会議室の予約などを、誰が読んでも実行できる順番で書き出してみましょう。
途中で選択がある場面は条件分岐、複数回行う作業は繰り返し処理として考えられます。
この練習を通じて、曖昧な表現を具体的な条件に変える感覚が身につきます。
たとえば、必要なら連絡するという表現ではなく、期限の2日前までに回答がない場合は担当者へ通知すると書けば、実行条件が明確になります。
日常の行動を細かく分ける練習は、論理的な手順を考える力を育てる近道です。
フローチャートと擬似コード
処理の流れを可視化する方法として、フローチャートと擬似コードがあります。
フローチャートは、開始、処理、判断、終了を図形と矢印で表し、全体の流れを直感的に確認する方法です。
擬似コードは、特定のプログラミング言語の厳密な文法に縛られず、日本語や簡単な英語で処理手順を書く方法を指します。
どちらも、コードを書く前に手順の矛盾や不足を見つけるために役立ちます。
会員ランクに応じて割引を決める場合は、会員ランクを取得し、上位ランクかを判定し、該当すれば割引率を設定し、該当しなければ通常価格を設定し、最終金額を表示するという流れに分解できます。
この段階で例外条件も加えると、実装前の確認がしやすくなります。
フローチャートで全体を見渡し、擬似コードで細かな判断を書き出すと、設計の精度を高めやすくなります。
複雑な処理ほど、いきなり完成形を目指さず、小さな単位に分けて確認する姿勢が有効です。
小さな問題からの実践
学習を定着させるには、簡単な問題を自分で解く経験が役立ちます。
数値の合計を求める、最大値を探す、重複を除く、文字列を逆順にする、条件に合うデータだけを抽出するといった課題から始めるとよいでしょう。
答えをすぐに見るのではなく、まずは紙に処理の流れを書き、自分の考えた手順で例を動かしてみることが重要です。
データが1件の場合、0件の場合、同じ値が複数ある場合などを試すと、見落としていた条件に気付けます。
慣れてきたら、複数の方法で同じ問題を解き、処理回数やわかりやすさを比べてみると、アルゴリズムの違いを実感しやすくなります。
正解を覚えるだけでなく、なぜその手順で動くのかを説明できるようになることが、理解を深めるポイントです。
まとめ
アルゴリズムとは、問題を解決し、目的を達成するための明確な手順です。
プログラムを書くための土台になるだけでなく、検索、整列、最適化、業務自動化、人工知能など、幅広い場面を支えています。
基本となる順次処理、条件分岐、繰り返し処理を理解すると、複雑に見えるシステムも段階的に捉えやすくなります。
また、処理時間、メモリ使用量、正確性、保守性をバランスよく考えることで、実用性の高い仕組みへ近づけます。
まずは身近な作業を手順に分解し、フローチャートや擬似コードで整理することから始めてみてはいかがでしょうか。
アルゴリズムを理解することは、コンピューターに詳しくなるだけでなく、日常や仕事の課題を整理して解決する力にもつながります。