確率は、くじやサイコロのような身近な場面から、品質管理、株価分析、機械学習まで幅広く使われる考え方です。
そのなかで重要になるのが、データがどのように散らばり、ある値以下になる可能性がどれほどあるかを示す確率分布関数と確率密度関数です。
名称が似ているため混同しやすいものの、表している内容や読み取り方にははっきりした違いがあります。
この記事では、確率分布関数と確率密度関数の役割、計算の基本、グラフの見方を順序立てて解説します。
確率分布関数と確率密度関数の全体像
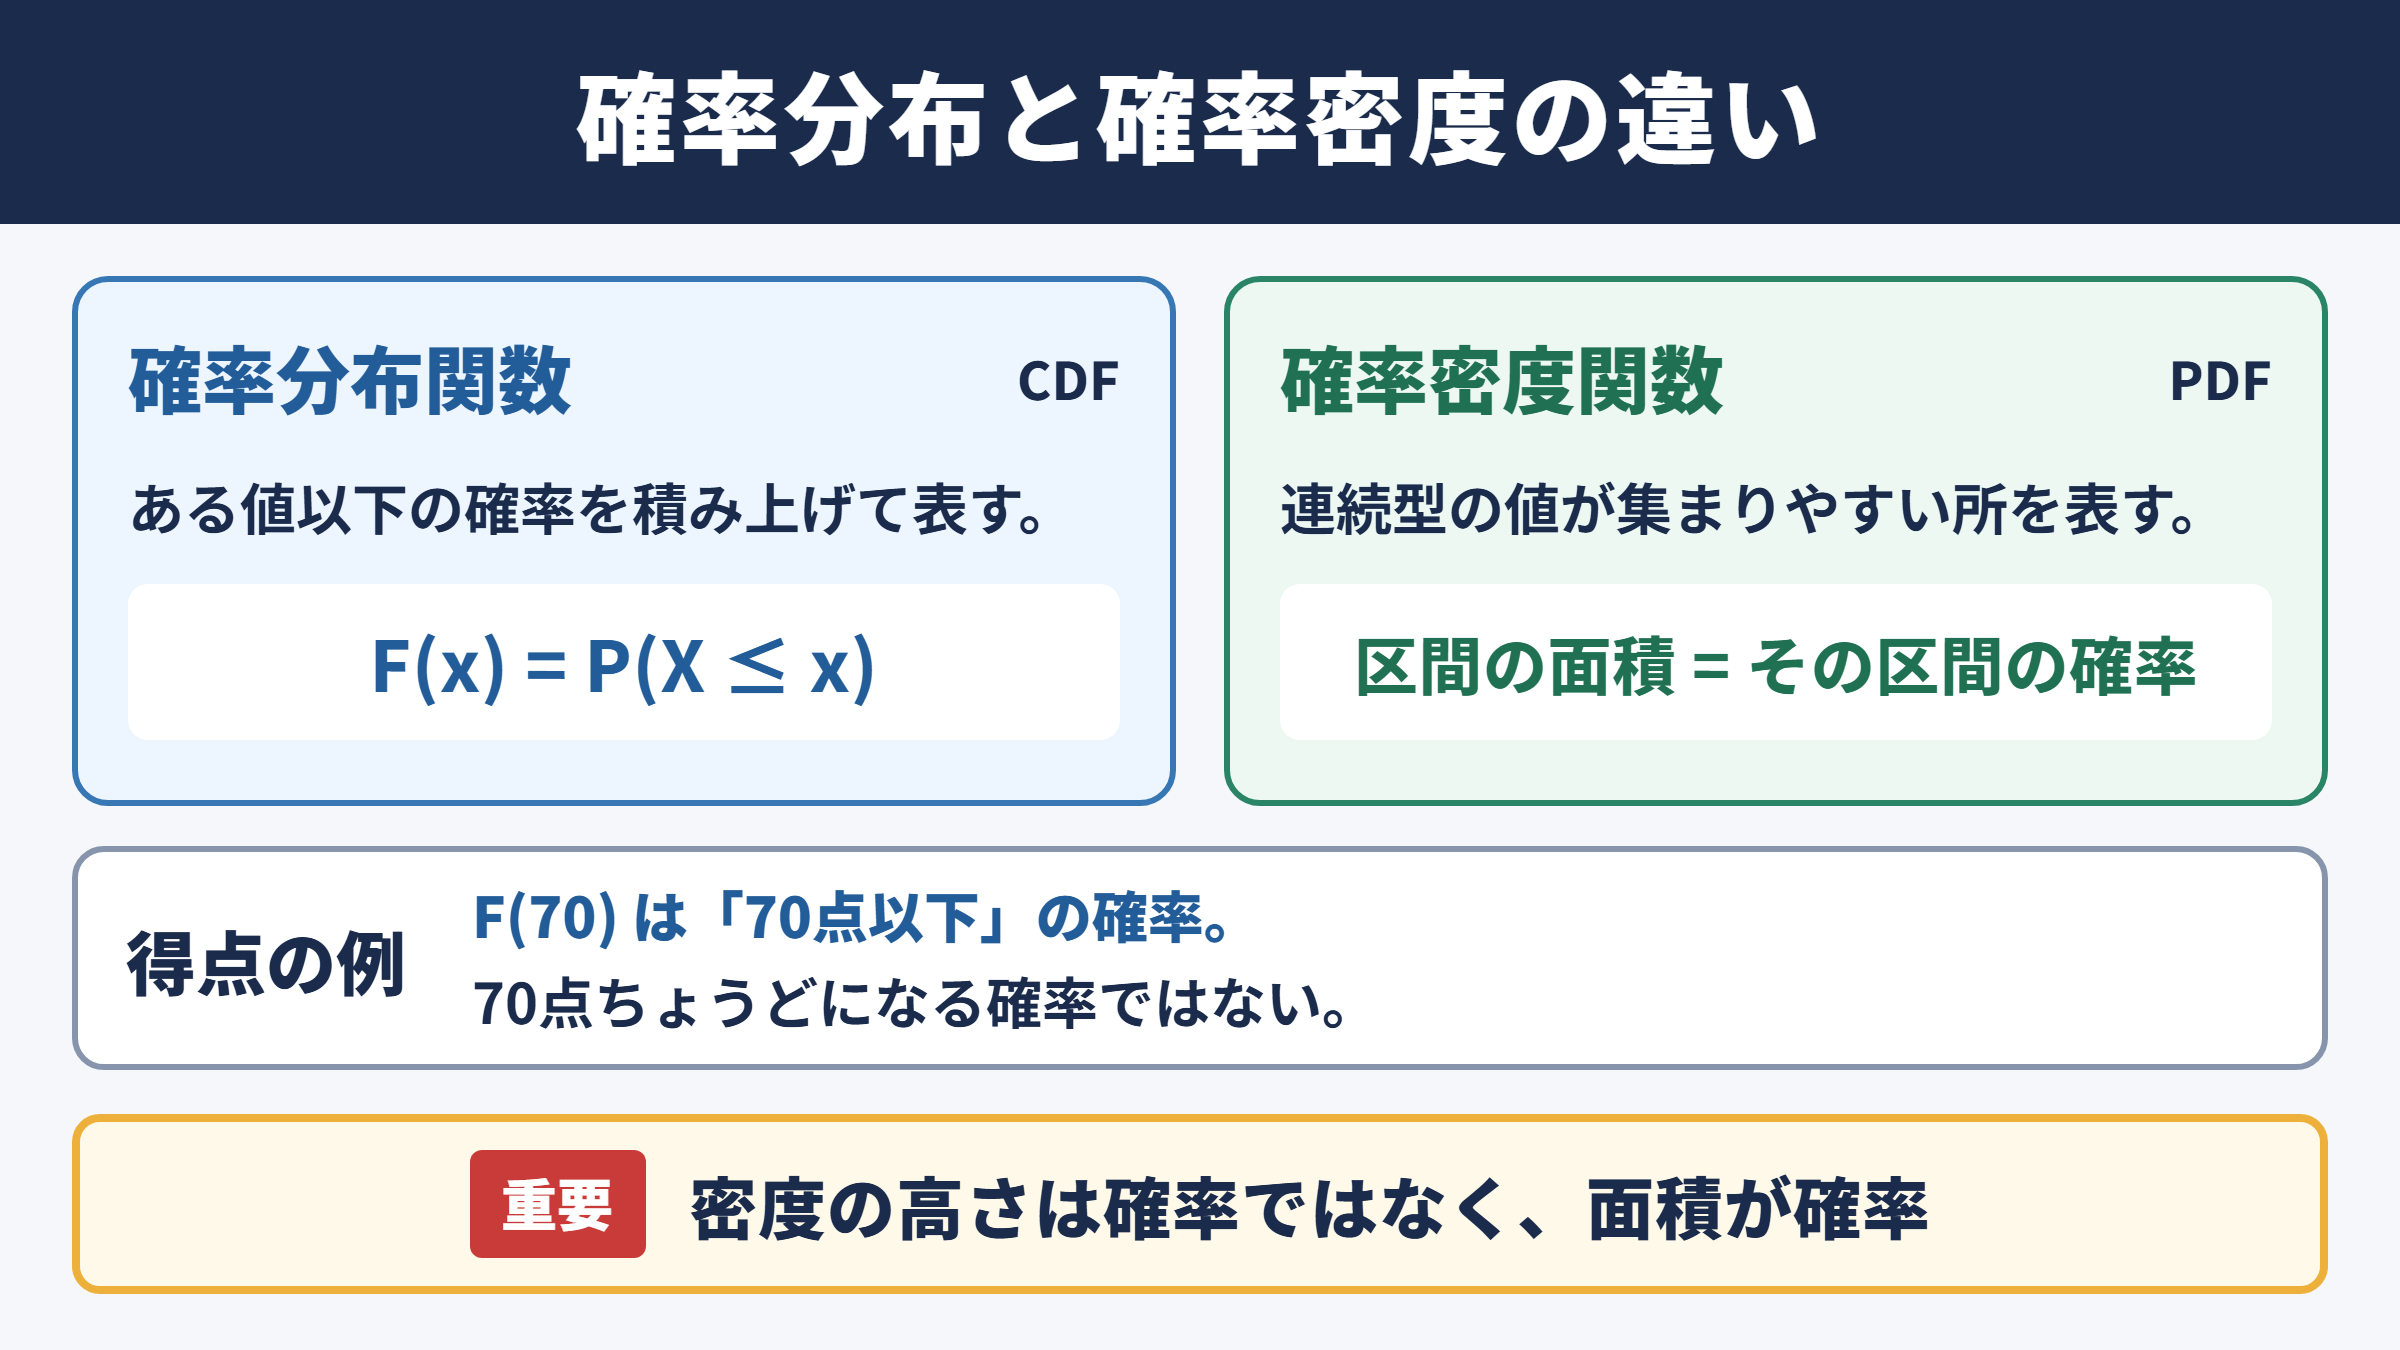
それではまず、確率分布関数と確率密度関数の違いについて解説していきます。
確率分布関数が表す累積確率
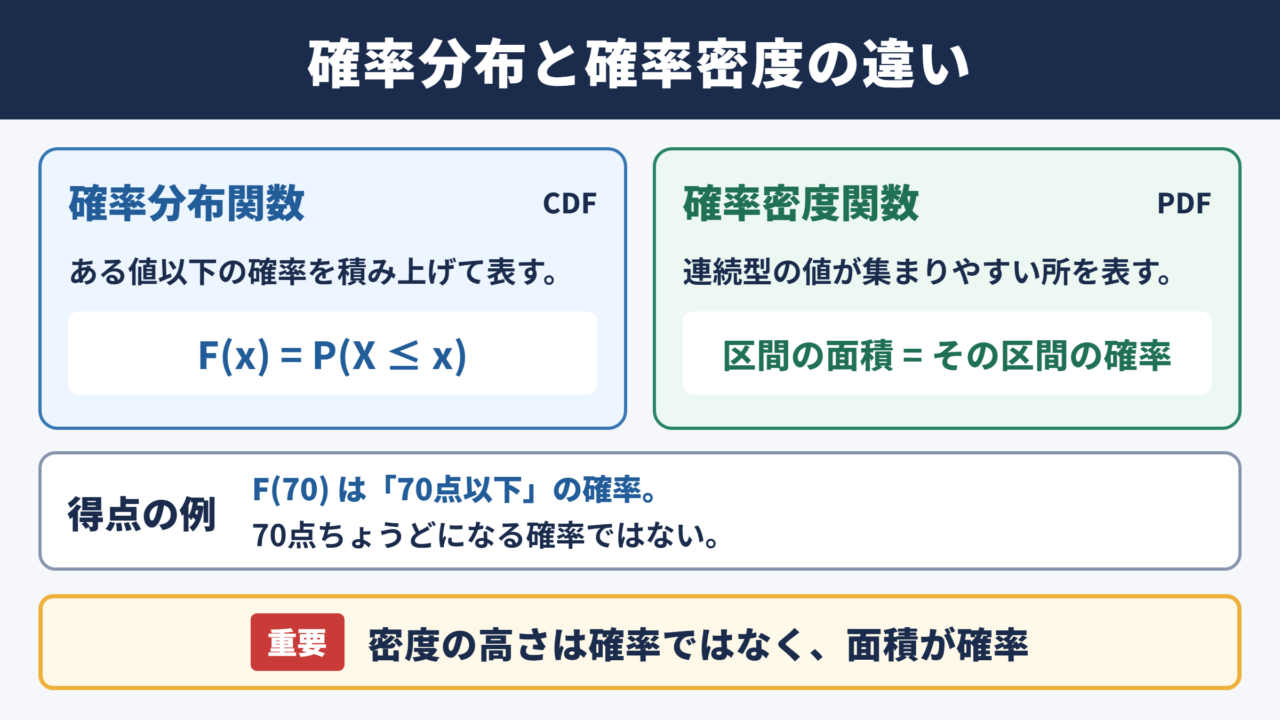
確率分布関数とは、確率変数がある値以下になる確率を表す関数です。
一般に確率変数をX、小文字のxを特定の値とすると、確率分布関数はF(x)で表されます。
意味は、Xがx以下となる確率です。
確率分布関数の基本形
F(x) = P(X ≦ x)
これは、確率変数Xがx以下に収まる確率を示します。
たとえばテストの得点を確率変数とした場合、F(70)は70点以下の得点になる確率を表します。
100点中70点を取る確率そのものではなく、70点以下に含まれるすべての確率を合計した値である点が重要です。
確率分布関数は累積分布関数とも呼ばれ、英語ではCumulative Distribution Functionの頭文字からCDFと表記されます。
値が小さい側から確率を積み上げていく関数と考えると、役割をつかみやすくなるでしょう。
確率密度関数が表す分布の濃さ
確率密度関数とは、連続型の確率変数において、値がどの付近に集まりやすいかを表す関数です。
一般にf(x)で表され、英語ではProbability Density FunctionからPDFと呼ばれます。
グラフでは山の高さとして描かれますが、その高さがそのまま確率になるわけではありません。
連続型の分布では、ぴったり一つの値を取る確率は通常0になります。
そのため、確率密度関数では区間の面積を求めて初めて確率が分かります。
確率密度関数から区間の確率を求める形
P(a ≦ X ≦ b) = aからbまでのf(x)の面積
数式では積分を用いて表します。
たとえば身長の分布では、170cmちょうどの人である確率ではなく、170cmから175cmまでに入る確率を考えます。
グラフの170から175までの範囲にある面積が、その区間に該当する確率です。
密度関数の縦軸は確率ではなく、確率が集中する度合いであることを押さえておきましょう。
両者の違いを整理する視点
確率分布関数と確率密度関数は関連していますが、用途は異なります。
確率分布関数はある値以下になる可能性を確認したいときに便利で、確率密度関数はどの範囲にデータが集まりやすいかを把握したいときに役立ちます。
| 比較項目 | 確率分布関数 | 確率密度関数 |
|---|---|---|
| 主な記号 | F(x) | f(x) |
| 表す内容 | x以下になる累積確率 | x付近に分布する濃さ |
| 値の範囲 | 0以上1以下 | 1を超える場合もある |
| 確率の読み方 | 関数値そのもの | 区間の面積 |
| 主な対象 | 離散型と連続型 | 主に連続型 |
確率密度関数の値が1より大きくても、確率が1を超えたことにはなりません。
幅の狭い範囲へ強く集中している場合、密度の高さが1を超えることもあります。
確率分布関数は累積した確率を示し、確率密度関数は確率を区間へ配分する形を示します。
両者を区別する際は、関数値を見るのか、グラフ下の面積を見るのかに注目すると理解しやすくなります。
確率変数と確率分布の基本構造
続いては、確率分布を理解する土台となる確率変数と分布の種類を確認していきます。
確率変数の意味
確率変数とは、偶然によって決まる数値を変数として表したものです。
サイコロを1回振って出る目、商品の購入金額、待ち時間、気温などが代表例になります。
通常の変数は任意の値を置く文字として扱われますが、確率変数には起こりやすさという情報が伴います。
たとえばサイコロの出目をXとした場合、Xは1から6の値を取ります。
公平なサイコロであれば、各値が出る確率は等しく6分の1です。
確率変数は数値と確率を結び付けるための入口であり、分布関数を学ぶ前に理解しておきたい要素です。
離散型確率変数と連続型確率変数
確率変数は、大きく離散型と連続型に分けられます。
離散型確率変数は、飛び飛びの値を取る変数です。
サイコロの目、来店客数、不良品の個数などは離散型にあたります。
一方で連続型確率変数は、ある範囲で連続的に値を取る変数です。
身長、体重、気温、製品の長さ、作業時間などが連続型の例になります。
| 種類 | 値の特徴 | 具体例 | 主に使う関数 |
|---|---|---|---|
| 離散型 | 数えられる値 | サイコロの目、人数、回数 | 確率質量関数、分布関数 |
| 連続型 | 途切れない値 | 身長、時間、温度、長さ | 確率密度関数、分布関数 |
離散型では、それぞれの値に確率を直接割り当てられます。
連続型では無数の値があり、一点ごとに正の確率を割り当てることはできないため、密度と区間で考える仕組みになります。
確率分布が持つ情報
確率分布とは、確率変数がどの値をどの程度取りやすいかをまとめたものです。
分布を見ると、中心がどこにあるのか、ばらつきが大きいのか、極端な値が出やすいのかが分かります。
平均値はデータの中心的な位置を示し、分散や標準偏差は散らばりの大きさを示す代表的な指標です。
同じ平均でも、ばらつきが違えば結果の安定性は変わります。
平均が50の二つの分布があっても、一方は45から55に集中し、もう一方は20から80まで広がるかもしれません。
平均だけでは分からない不確実さを読み取れる点が、確率分布を扱う大きな価値です。
確率分布関数の性質とグラフの読み方
続いては、確率分布関数が持つ基本的な性質とグラフの見方を確認していきます。
値の範囲と単調増加
確率分布関数F(x)の値は、必ず0以上1以下に収まります。
確率を表しているため、負の値になったり1を超えたりすることはありません。
また、xが大きくなるほどF(x)は小さくなりません。
より大きな値以下という条件には、それより小さい値以下の範囲もすべて含まれるためです。
この性質を単調非減少といいます。
確率分布関数の基本的な性質
0 ≦ F(x) ≦ 1
xが増えるとF(x)は減少しない
xが十分小さいとF(x)は0に近づき、十分大きいと1に近づきます。
グラフを確認するときは、左下付近から始まり、右上へ向かって上昇していく形をイメージするとよいでしょう。
途中で下がるグラフは、通常の確率分布関数としては成り立ちません。
離散型分布における階段状の形
サイコロの目のような離散型確率変数では、確率分布関数は階段状のグラフになります。
たとえば公平なサイコロでは、Xが1以下である確率は6分の1です。
Xが2以下である確率は、1または2が出る確率なので3分の1になります。
値が1から2の間にあっても、サイコロの出目は変化しません。
そのため、その区間では確率分布関数の高さも変わりません。
出目に該当する値に到達したときだけ、確率が積み上がって段差が生まれます。
離散型の確率分布関数では、段差の大きさがその値を取る確率に対応します。
階段の一段ごとの上昇量を見ると、どの値がどれほど起こりやすいかを読み取れます。
連続型分布における滑らかな形
身長や時間のような連続型確率変数では、確率分布関数は一般に滑らかな曲線として描かれます。
確率密度関数が高い区間では、確率分布関数の傾きが急になります。
反対に、密度が低い区間では、累積確率の増え方も緩やかです。
正規分布のように中央付近へデータが集まる分布では、確率分布関数は中央部分で大きく立ち上がるS字型に近い形になります。
この関係を理解すると、分布関数と密度関数のグラフを結び付けて読めるようになります。
分布関数の傾きが大きい場所は、データが集まりやすい場所と考えるのが基本です。
確率密度関数から確率を求める方法
続いては、確率密度関数を使って区間の確率を求める考え方を確認していきます。
グラフ下の面積による確率計算
確率密度関数では、グラフと横軸で囲まれた面積が確率を意味します。
全範囲の面積を合計すると、必ず1になります。
これは、確率変数が取り得るすべての値のどれかを取る確率が100パーセントであることに対応します。
区間aからbに入る確率は、その範囲の下にある面積を求めます。
面積を正確に計算するには積分を使いますが、基本的な形を理解することが先決です。
山の高い場所でも、区間の幅が極端に狭ければ面積は小さくなります。
反対に高さがそこまで大きくなくても、広い区間を取れば確率は大きくなります。
一様分布による基本例
確率密度関数の計算を学ぶには、一様分布が分かりやすい例になります。
一様分布とは、ある範囲で密度が一定となる分布です。
たとえば0から10までの範囲で一様に値を取る場合、密度関数の高さは10分の1です。
0から10までの一様分布の例
f(x) = 10分の1
2から5までに入る確率は、幅3に高さ10分の1を掛けて10分の3になります。
この例ではグラフが長方形になるため、面積は幅と高さの掛け算で求められます。
複雑な関数でも、考え方は同じです。
曲線の下にある面積を求めることで、指定した範囲に入る確率が分かります。
確率密度関数と累積分布関数の変換
連続型の分布では、確率密度関数を左側から積み上げると確率分布関数になります。
反対に、確率分布関数を微分すると確率密度関数が得られます。
つまり、両者は別々の概念でありながら、計算上は密接につながっています。
確率密度関数がf(x)、確率分布関数がF(x)である場合、F(x)はxまでの密度の面積です。
また、F(x)の変化の速さがf(x)に対応します。
確率密度関数から確率分布関数へは積分、確率分布関数から確率密度関数へは微分という関係があります。
この対応を知ると、問題文でどちらの関数が与えられていても必要な確率へたどり着きやすくなります。
代表的な確率分布と活用場面
続いては、よく使われる確率分布と、それぞれが活用される場面を確認していきます。
二項分布とベルヌーイ試行
二項分布は、成功か失敗かの二つの結果を持つ試行を複数回行ったときに、成功回数がどう分布するかを表します。
コイン投げで表が出た回数、広告を見た人が購入した人数、検査品のうち不良となった個数などが例です。
一回の成功確率が一定で、各試行が独立していることが主な前提になります。
成功確率が低く試行回数も少ない場合は、成功回数が少ない側へ確率が集まりやすくなります。
品質管理やマーケティングでは、発生件数の予測や目標達成の可能性を考える際に利用されます。
正規分布と標準偏差
正規分布は、中央が最も高く、左右対称の釣鐘型をした代表的な連続確率分布です。
身長、測定誤差、試験結果、製造工程における寸法のばらつきなど、多くの自然現象や集団データの近似に使われます。
正規分布では平均が中心の位置を決め、標準偏差が広がり方を決めます。
標準偏差が小さいほど、データは平均付近へ密集します。
標準偏差が大きいほど、分布は横へ広がり、極端な値も現れやすくなります。
平均と標準偏差を組み合わせて見ることが、正規分布を実務で使う際の基本になります。
指数分布と待ち時間
指数分布は、次の出来事が起こるまでの待ち時間を表す際によく使われる分布です。
電話がかかってくるまでの時間、故障が発生するまでの時間、ある時点から次の来客があるまでの時間などが代表例です。
指数分布には、すでにどれだけ待ったかが今後の待ち時間へ影響しないという特徴があります。
この性質は無記憶性と呼ばれます。
すべての現象に当てはまるわけではありませんが、ランダムな到着や発生をモデル化する際の基本的な選択肢になります。
| 確率分布 | 主な対象 | 活用例 |
|---|---|---|
| 二項分布 | 成功回数 | 合格者数、不良品数、成約件数 |
| 正規分布 | 中心のある連続データ | 身長、測定値、品質管理 |
| 指数分布 | 発生までの時間 | 待ち時間、故障間隔、到着間隔 |
| 一様分布 | 範囲内で均等な値 | 乱数、単純なシミュレーション |
確率分布関数を扱う際の注意点
続いては、確率分布関数と確率密度関数を扱う際に見落としやすい点を確認していきます。
一点の確率と区間の確率の区別
連続型確率変数では、特定の一点を取る確率は0です。
これは、その値が絶対に起こらないという意味ではありません。
連続した無数の候補のなかで、幅を持たない一点に面積を割り当てないという数学的な扱いです。
身長が170cmちょうどである確率は0と表現されても、170cm付近の人が存在しないわけではありません。
実務では測定単位や許容範囲を考慮し、169.5cmから170.5cmのような区間で確率を考えます。
連続型では一点ではなく範囲で確率を読むことが大切です。
密度の高さと確率の混同
確率密度関数のグラフが高い部分は、値が集まりやすい範囲を示します。
ただし、縦軸の高さそのものを確率として読んではいけません。
確率になるのは、指定した区間におけるグラフ下の面積です。
とくに横幅が異なる区間を比較するときは、高さだけでは判断できません。
細く高い山と、低く広い山では、どちらの範囲により大きな確率が含まれるかを面積で確認する必要があります。
分布の前提とデータの確認
正規分布や二項分布などの公式を使う前に、データが前提条件におおむね合っているかを確認することが欠かせません。
極端に偏ったデータへ正規分布を当てはめると、計算結果が現実と離れる可能性があります。
二項分布でも、試行ごとの成功確率が大きく変化する場合や、試行同士が強く影響し合う場合には注意が必要です。
ヒストグラムや散布図でデータの形を確認し、平均、中央値、標準偏差、外れ値もあわせて見ると判断しやすくなります。
数式を当てはめる前に、データの特徴と目的を確かめる姿勢が分析の精度を左右します。
確率分布関数と確率密度関数のまとめ
ここまで、確率分布関数とは何か、確率密度関数との違い、基本的な求め方を解説しました。
確率分布関数は、ある値以下になる累積確率を示す関数です。
確率密度関数は、連続型データがどの値の付近へ集まりやすいかを示し、区間の面積によって確率を求めます。
両者は積分と微分の関係で結ばれており、グラフを使うことで直感的にも理解できます。
離散型では階段状の確率分布関数、連続型では滑らかな分布関数と密度関数を意識すると、問題の見方が整理されるでしょう。
平均や標準偏差、分布の形、前提条件にも目を向ければ、統計やデータ分析で確率の考え方をより正確に活用できます。
確率を一点ではなく分布として捉えることが、確率分布関数を使いこなす第一歩です。